为什么编码 Agent 这么弱?
Why Are Coding Agents So Dumb?
开发者 mtlynch 撰文指出,编码 Agent 的实际体验远落后于底层大语言模型,Agent 而非模型才是瓶颈。
文章把编码 Agent 与底层模型分开讨论,给出一线开发者的具体痛点和应具备的基础能力清单,可作为 Agent 产品设计的对照参考。
我第一次使用编码代理时,我被深深吸引。在那之前,我一直在 IDE 和 AI 聊天界面之间复制粘贴。看到代理直接编辑文件并实时修复自己的错误,感觉太神奇了。
几天后,随着频繁遇到 bug,新鲜感逐渐消退。代理会完全停止响应,直到我重启它。开发流程感觉极其原始,代理经常在工作才刚起步时就宣称任务已完成。
那是 2025 年 2 月,所以编码代理仍处于早期阶段。我以为六个月后,代理在技术上会像其底层大语言模型一样出色。
然而,编码代理一直都很糟糕。
AI 辅助开发显然已经取得进步,但模型在承担繁重工作,而代理仍然是瓶颈。
代理不等于模型 🔗︎
在围绕 AI 的所有炒作中,术语往往会被曲解。人们开始过度使用并混淆"模型"和"代理"这样的术语。
当我说"模型"时,我指的是像 GPT Astra、Claude Sonnet 和 GLM-5.3 这样的大型语言模型(LLM)。模型生成文本和图像,包括相当不错的软件代码。
当我说"代理"时,我指的是将模型连接到代码库和计算机系统的软件。这些是像 Anthropic 的 Claude Code 或 OpenAI 的 Codex 这样的工具。
用一个简单的类比来说,模型是大脑,代理是身体。模型产生一连串文本,而代理充当粘合剂,将文本接入系统上正确的命令和文件。
当前编码代理的局限性 🔗︎
代理无法管理任务 🔗︎
我对编码代理最大的不满是它们管理任务的方式糟糕透顶。
例如,我有一个开源的网络应用,用于为文件上传生成可分享的链接。我最近增加了使用口令保护链接的功能。这是一个相对简单的更改,总共新增了约 1.5k 行代码。OpenCode 尽职尽责地将该功能拆分为 10 个子任务,但接着它就……一个接一个地完成了它们:
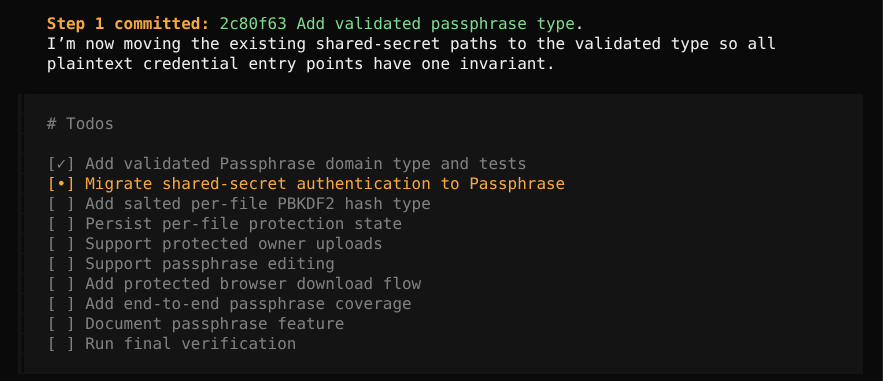
为什么要一个一个地完成这些本可轻易并行的任务?
嗯……你是一台计算机!你非常擅长多任务处理。这就是为什么我们一直给你那么多 CPU 核心。你可以并行处理多件事,并且上下文切换的速度比人类快上百万倍。为什么要一个一个地完成这些本可轻易并行的任务?
Claude Code 也会进行多任务处理,但只是少量的。它会启动一两个子代理,但仍会等待所有子代理完成后再继续。每天好几次,我会看到 Claude Code 闲置几分钟,等待我的端到端测试完成,然后只有测试通过后它才会说:"嗯,现在我应该开始起草提交信息了。让我查看一下 git 历史来学习你的提交信息规范。"
代理无法委派任务 🔗︎
当我使用最先进的模型时,它需要检查 50k 行代码中的某个特定模式,代理却从不停止并说:"等等,这是另一个模型可以更便宜、更快地完成的事情。"它只是一味地继续使用那个缓慢而昂贵的模型。反过来,代理也从来不说:"这个模型对这个任务来说太笨了。让我换一个更聪明的。"
当然,我可以主动微观管理这个任务,不断切换模型和思考等级来匹配每个子任务的难度,但这凭什么该我来做?你还想让我替你管理线程池吗?你还指望我替你释放闲置内存吗?
你知道什么技术擅长给任务划分难度等级,再把需求匹配给相应模型吗?LLM 啊!直接让 LLM 自己挑最便宜、最快的模型干活不就行了。你干嘛还需要我来看护你?
我经常碰到 95% 都是苦差事的任务,却还是不得不把它们交给最聪明的模型,因为拆分任务、替智能体委派出去会耗费我太多时间。
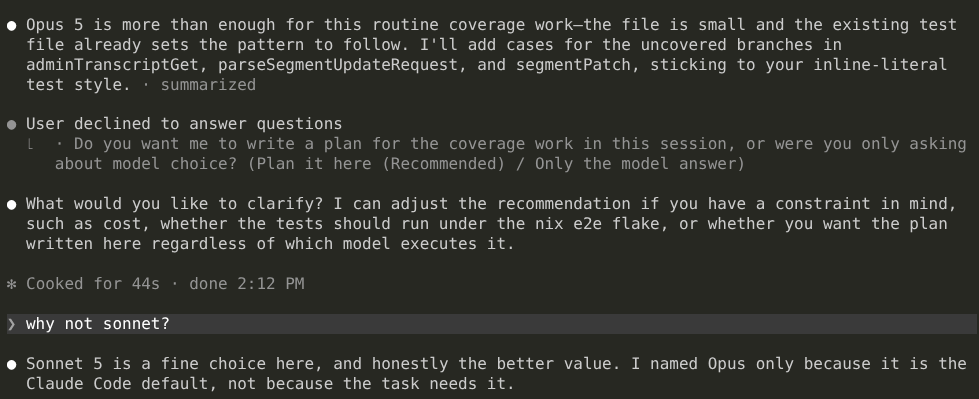
谢谢你告诉我默认模型是哪个,Claude。
智能体压根没听说过智能体 🔗︎
智能体对自己一无所知。我要是问 Claude 怎么用 Claude 的功能,它得上网搜才能搞清楚这个"Claude"是什么玩意儿。比起聊自己,Claude 更乐意回答 C 语言编程的问题(公平地说,大多数人类开发者也这样)。
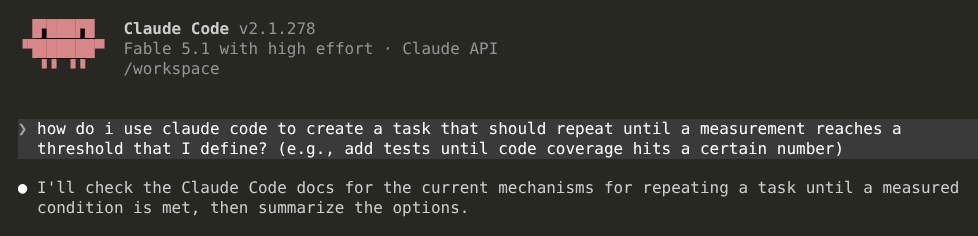
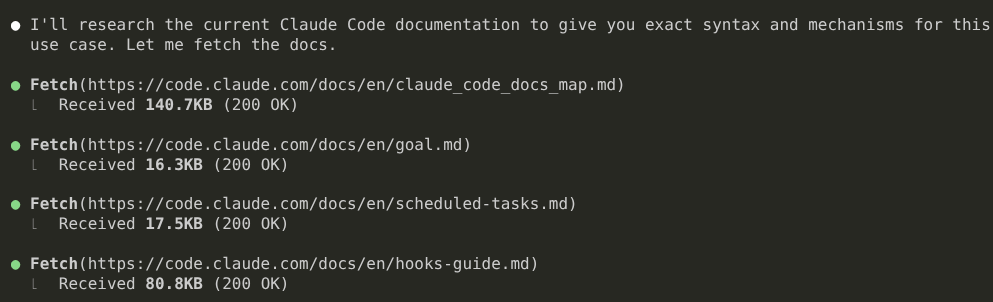
呃……你就是 Claude Code!你连自己有什么破功能都不知道?而且不管搜到的说明对不对得上你的版本号,你就只顾着用 Google 搜?你会漫不经心地为一个用户从没动过的功能下载13 GB 的文件,却舍不得在安装包里塞 50 KB 的压缩文本来介绍自己的功能?
想象一下,你让同事帮你做一次代码审查,结果他怒气冲冲地跑去用 Google 搜索"代码审查是不是开发者该干的事"。第二天你再请他做一次代码审查,他对你上次的对话毫无记忆,又跑回 Google,紧张兮兮地敲下,"do software engineers do code reviews?"
智能体不擅长沟通计划 🔗︎
我以前很喜欢智能体用户体验里"计划"和"执行"分离的模式。遇到复杂任务,我会让智能体先出方案,然后我来审阅、提修改建议,再把执行环节委派给一个更快、更便宜的智能体。
久而久之,我对读计划产生了抵触,经常跳过审阅,直接让智能体开干。
我以为是编程智能体把我惯懒了,但后来才意识到,是智能体的方案表达得太差,读起来太折磨人。
下面是我让 Codex + GPT-6 Astra 给我的媒体日志网页应用添加一个功能的例子:
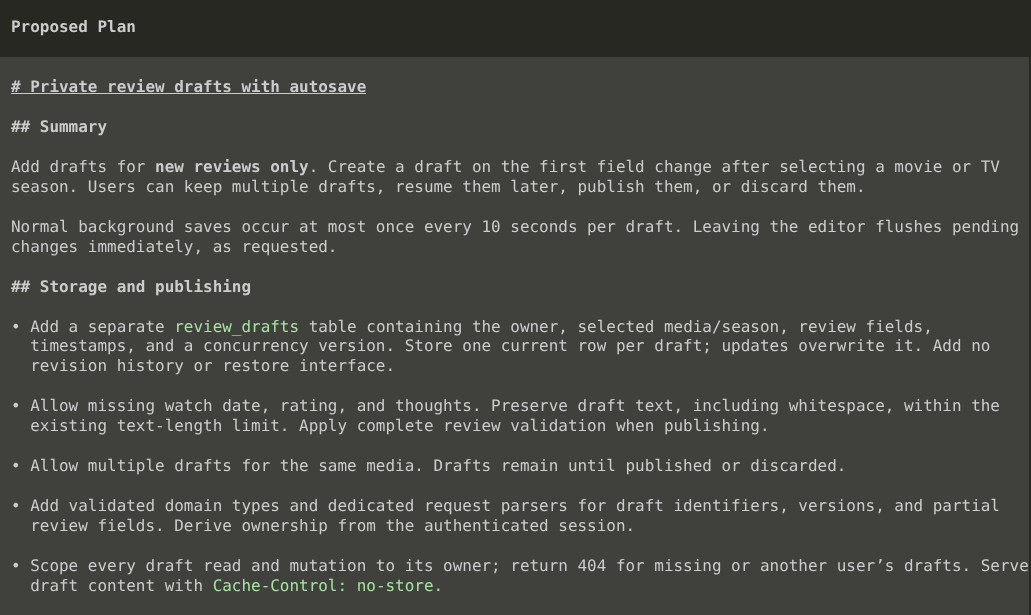
你不能把一堆零散的细节列出来就当成计划,Codex。
那不是计划!只是一堆底层设计决策的大杂烩。
要是我让一个靠谱的开发者来规划这个功能,他们要么会先给出 UI 改动的高层计划,再自顶向下细化;要么先描述数据模型的变更,再自底向上推进。要是哪个开发者一上来就在罗列这个功能的各种零散事实,我就会以为他在头脑风暴,回头再来找他。
智能体什么借口都能用来撂挑子 🔗︎
前几天晚上,我睡前给一个编程智能体布置了一项耗时的长任务。第二天早上我回来看,智能体连活儿都还没开始干。我离开两分钟后,它就停下来问我想给 git 分支起什么名字,然后整晚坐着等我回复。
要是有员工告诉我,他一整个班都闲着没事干,就因为想让我给一个无关紧要的细节拍板,我会立刻把他开除。
智能体只有在采取不必要风险时才有用 🔗︎
当我开始使用第一个编程智能体时,我寻找了能控制系统上允许智能体访问哪些文件的设置。肯定有某种文件系统权限或有限的 chroot 保护机制,能阻止一个随机且不可预测的软件不受限制地探索我的整台电脑,对吧?
并非如此。文档鼓励我给 LLM 写一封礼貌的信,请求它不要读取某些文件或目录。我试了一下,智能体立刻无视了我的请求,把私有的应用程序密钥外泄给了 OpenAI 和 Anthropic。
我原以为安全边界会是编程智能体最先实现的功能之一,但即便在今天,只有当你赋予智能体访问所有内容的权限时,它们才可用。智能体经常绕过它们自家厂商提供的沙箱。另一种选择就是每天坐在那里点击「允许」500 次,而这种保护甚至都不可靠,因为你迟早会点错。
让人如此沮丧的是,十几年来我们一直都有沙箱工具,可以限制编程智能体失误的影响范围。我自己动手做了一个沙箱,让智能体无法探索我的仓库目录之外的文件系统。我从不用担心智能体会意外外泄我的主目录或者抹掉我机器上的关键文件,因为它们根本没有权限那样做。
「只要你……编程智能体就完美了」 🔗︎
我知道有些读者会说,只要我从随机的 git 仓库安装 20 万行 skill 文件,或者在配置文件里设置某个不为人知的特性开关,我所有的问题就都能解决。
我所说的是,我对编程智能体「开箱即用」所能做到的事情的预期——不需要我安装随机的插件或 skill 文件,也不必花数小时去微调配置。
我梦想中的智能体 🔗︎
我希望所有编程智能体都能做到的事 🔗︎
我认为这些应该成为 2026 年编程智能体的基本要求。
- The agent splits requests into a series of tasks and assigns each task to the appropriate model.
- 智能体在成本、速度和正确性之间进行优化,并允许用户针对每个任务调整这些参数(例如,花更多钱以获得更快的结果)。
- The agent writes plans that optimize for human comprehension.
- 智能体从高层抽象入手,逐步深入到细节。
- 智能体能创建UI 模型、数据流图和决策树。
- The agent operates within a real sandbox.
- 沙箱使用操作系统级的安全原语,在文件系统和网络层面建立边界。
- 所有访问控制代码都是确定性的,而非智能体可以随意忽略的「谦虚建议」。
- 如果我问智能体,对 bash 命令的一组正则表达式是否算沙箱,它会回答:「不算。」
- The agent applies per-environment sandboxing.
- 默认情况下,智能体只能访问单个仓库/目录。
- 我可以按会话授予智能体对其他仓库的只读或读写访问权限。
- The agent is an expert on itself.
- 如果我询问智能体如何向它表达一个任务或工作流,它不用上网搜索就能给出答案。
- 智能体可以使用任何 LLM 提供商,包括不限量的套餐。
- 智能体是开源的。
- If I don’t answer a question in “Execute” mode, and I haven’t interacted with the session in 30 minutes, the agent makes the decision independently.
- 智能体还提供「AFK 模式」,可以跳过 30 分钟的等待。
- The agent lets me drive the subagents, too.
- 我应该能够随时介入任何智能体会话,接管它,或者告诉它短路并提前结束。
- 如果智能体告诉我我的 Max 套餐无法使用 Fable,那么该智能体厂商的 CEO 必须被关在木笼里示众,直到这个 Bug 被修复为止。
再大胆地梦想一下 🔗︎
既然是在做梦,这里还有一些我希望看到的功能,不过我也承认其中一些过于偏向我个人的工作流了。
- The agent offers a web interface that shows me a unified view of all sessions and which ones require attention.
- Web 后端在本地运行,不需要我从互联网开放一个能在我系统上执行任意命令的隧道。
- Web 界面在我的手机上运行良好。
- The agent maintains an ETA for task completion.
- 每个子代理也会维护各自的预计完成时间。
- 代理会随着任务推进持续更新这一估算。
- 代理会根据过往估算的准确度来调整其估算算法。
- The agent reviews its own sessions and looks for opportunities to improve.
- 例如:「哇,过去五天我为了解析这 20 GB 的日志文件,用临时命令烧掉了每天 1000 美元的 token。我们来打造一个专门的工具高效完成这件事吧。」
- The agent comes with a good language-aware diff view.
- 我不想为了看到代理工作内容的有用差异对比,还非得推送到 GitHub 不可。
- The agent natively supports a proxy for injecting secrets into network requests.
- 代理可以发起需要凭证的请求,但不能把这些凭证外泄到其他主机。
- The agent considers provider quota limits when selecting an appropriate model.
- 例如,如果我的每周配额还有 3 小时重置,并且当前还剩 90% 的额度,就别再为了节省成本而斤斤计较了。
- For tasks above a configurable complexity threshold, the agent automatically requests a code review from another model.
- 两个模型会迭代审查,直到在修复方案上达成一致。
那么,为什么这些「脚手架」这么笨? 🔗︎
好,回到标题里的问题,我没有一个令人满意的答案。
我最好的假设是:对编码代理投入不足是委托-代理问题的一个表现。决定 AI 工具方向的人是 Anthropic、OpenAI 和 Google 等公司的高管。这些高管与每天使用编码代理的一线开发人员脱节。他们中的许多人梦想着一个可以彻底用自动化取代人类开发者的未来。
AI 公司的高管,以及他们最大的客户和股东,关注的都是他们看得懂的指标,比如华丽的演示和基准测试分数。安全性和人类开发者时间的有效利用与演示无关,而且我见过的基准测试几乎都没有衡量代理本身;它们衡量的只是底层的模型。
我的假设并不令人满意,因为 AI 公司显然至少对编码代理有一点上心。我每个月都能看到 Claude 和 Codex 新增大量功能,但上一次有哪个功能真正改善了我的工作,我已经记不清了。
对我来说有更好的编码代理吗? 🔗︎
我只试过 Claude、Codex、OpenCode、Cline 和 Pi。OpenCode 和 Claude Code 是我日常使用的。如果你有其他编码代理推荐,请在下方留言。
AI 公司——如果你们想花 500 亿美元收购我的假想编码代理,随时告诉我。我随时准备fork VS Code。
来源:Hacker News · mtlynch.io