作者用 Dwitter 语料和个人偏好后训练 Demoscener-7B 以续写 Dweet 动画
I post trained a model on Demoscenes
作者在 Hugging Face 提供 Demoscener-7B,以 Dwitter 语料和人工偏好后训练,为 Dweet 动画生成续写。
文章拆解了从语料构建、课程训练到人工偏好 RLHF 的后训练流程,并给出各阶段困惑度变化,为小样本代码模型后训练提供了具体路径。
demoscene 的语法与未完成代码的可能性
October 31, 2026
最近,我一直对 demoscene 和 sizecoding 的世界着迷,后来偶然发现了 HellMood 引人惊叹的 MS DOS 演示作品 “Memories”。 在阅读他的 技术文章 时,我开始对作者是如何构思出其中一些视觉效果感到兴趣。我很难独立做出任何效果,因此希望从中获取一点灵感。
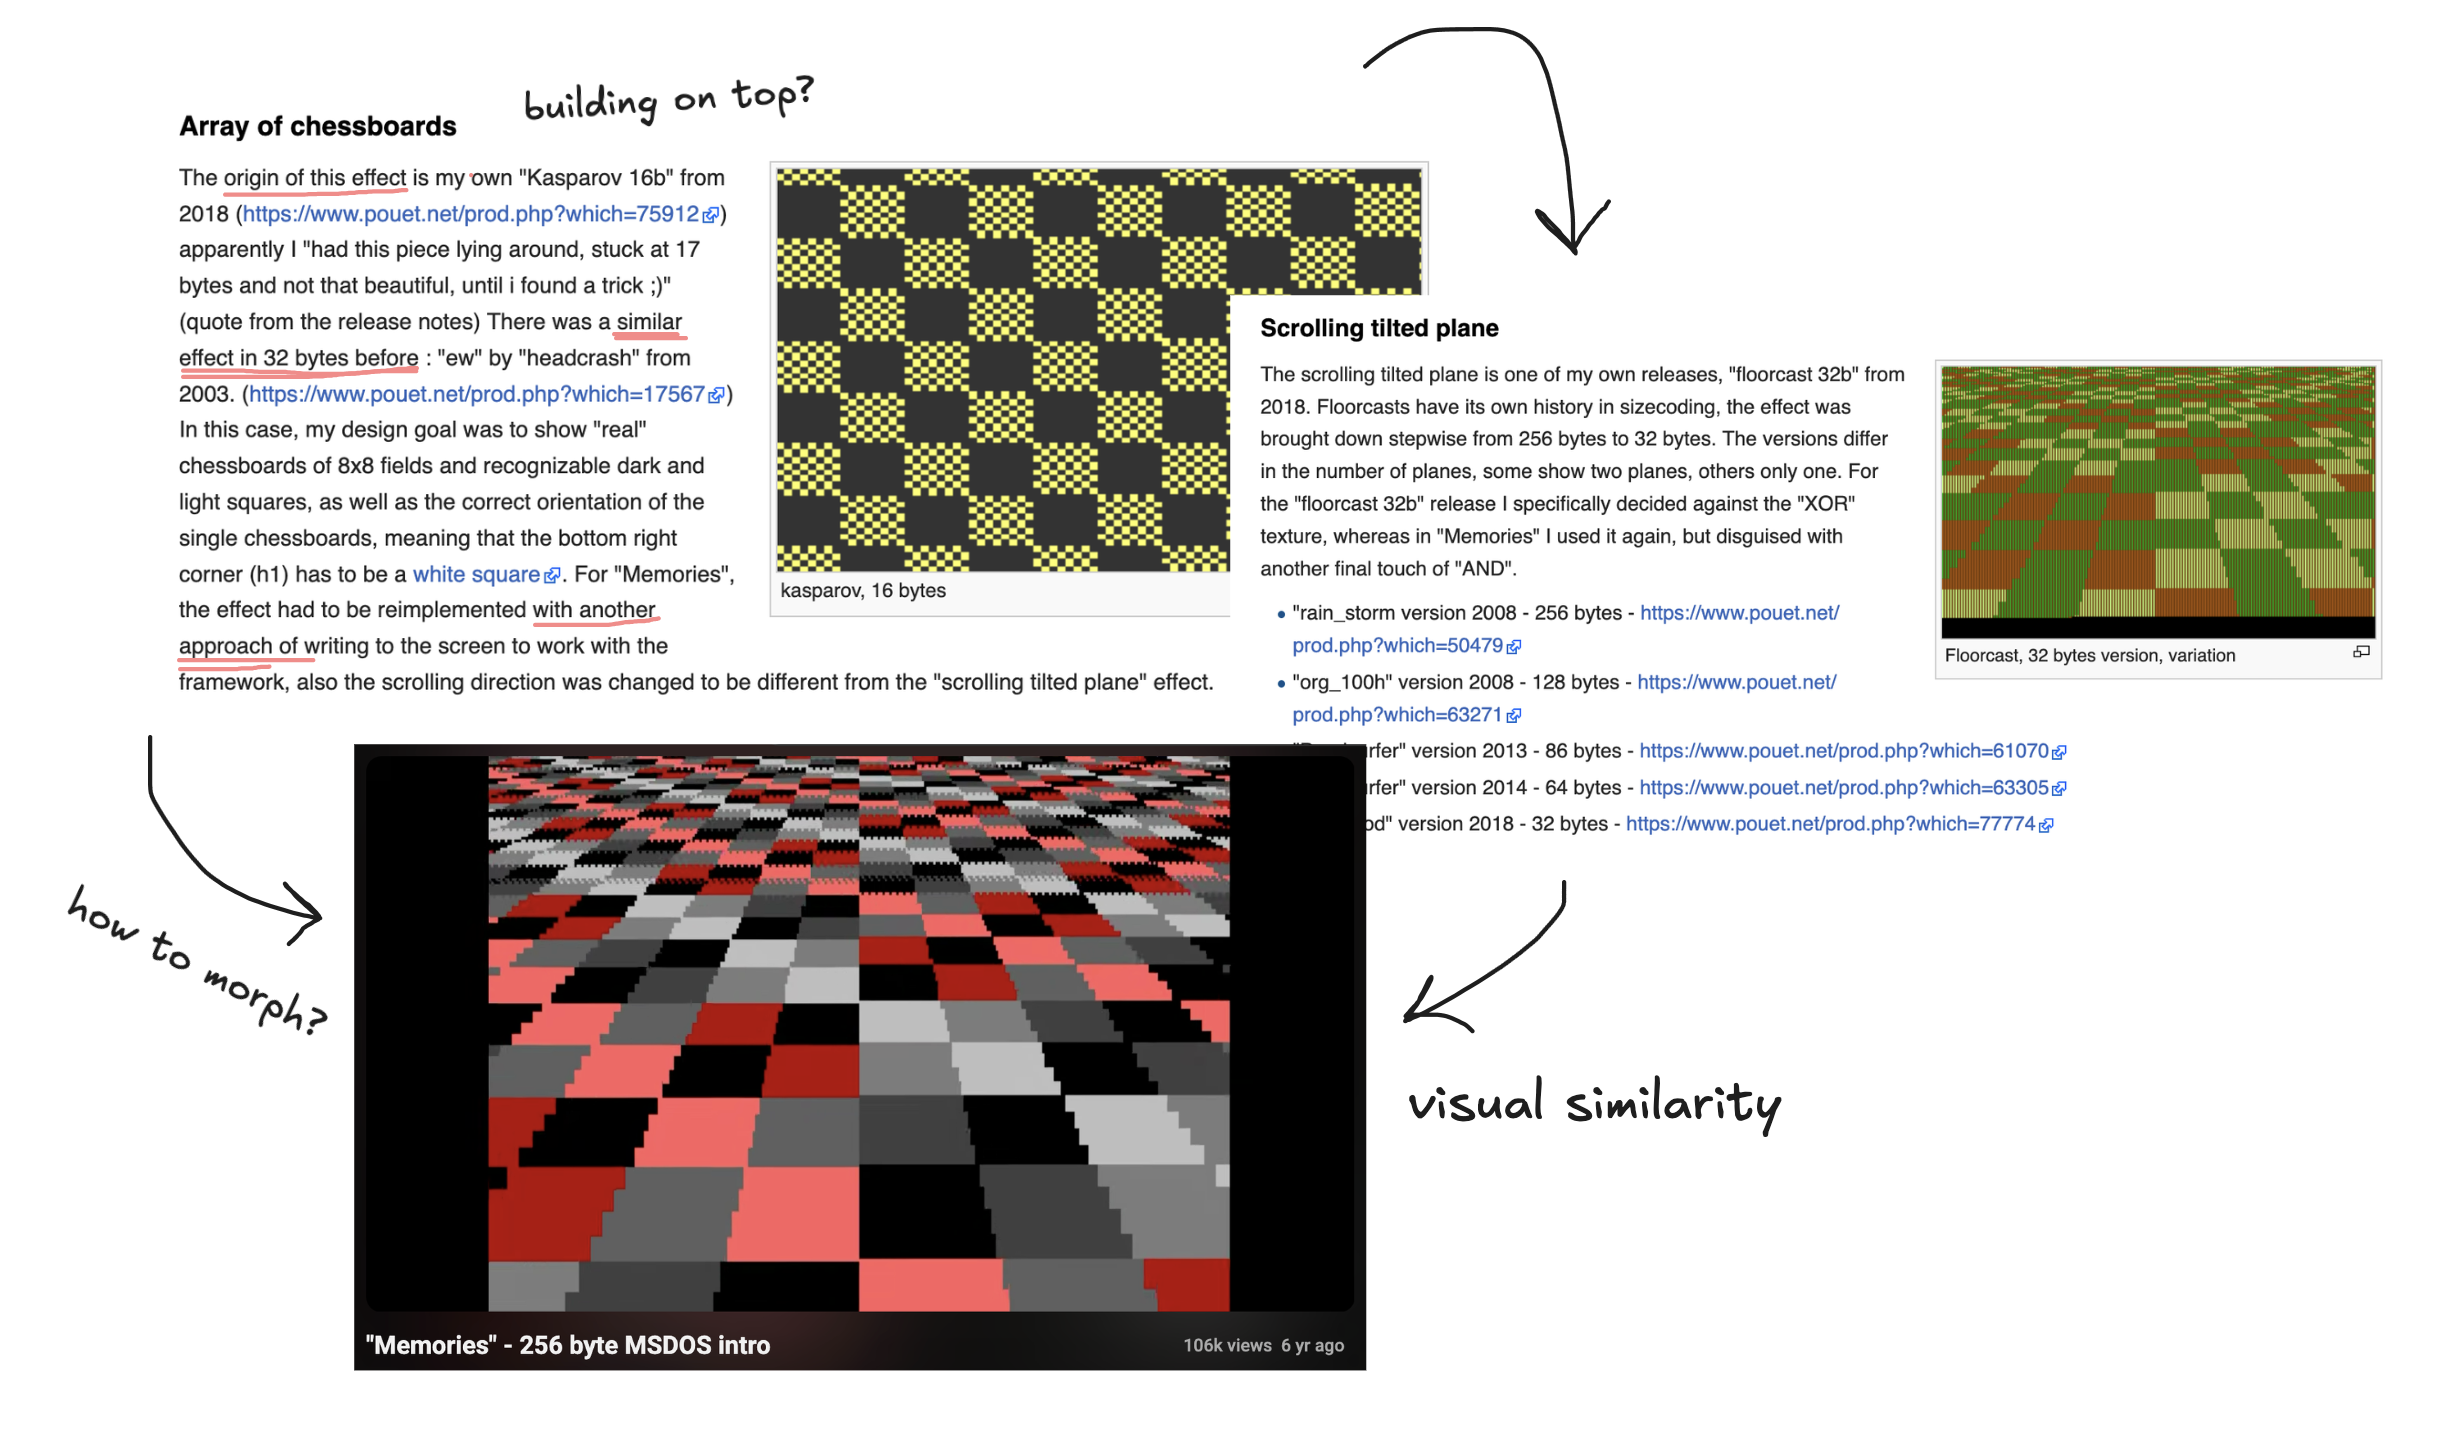
我注意到,这些效果都可以追溯到更早的实验:这些实验采用了不同的实现方式,也借鉴了此前若干演示作品中的若干想法。我开始思考,同一些底层思想还可能延伸出多少其他方向。我决定先从几个现有的演示作品入手——其中最简单的几个——然后逐字符修改它们,观察这些变化会如何影响视觉观感。
我发现了 Dwitter.net,它类似于 Twitter,但专门用于 140 字符的 JavaScript 演示作品。网站当时已经支持对任意 dweet 进行“remix”,让我们可以在其基础上继续创作。巧合的是,网站上获赞最多的 Dweet 采用了与 Memories 中视差棋盘格效果相同的视觉效果!
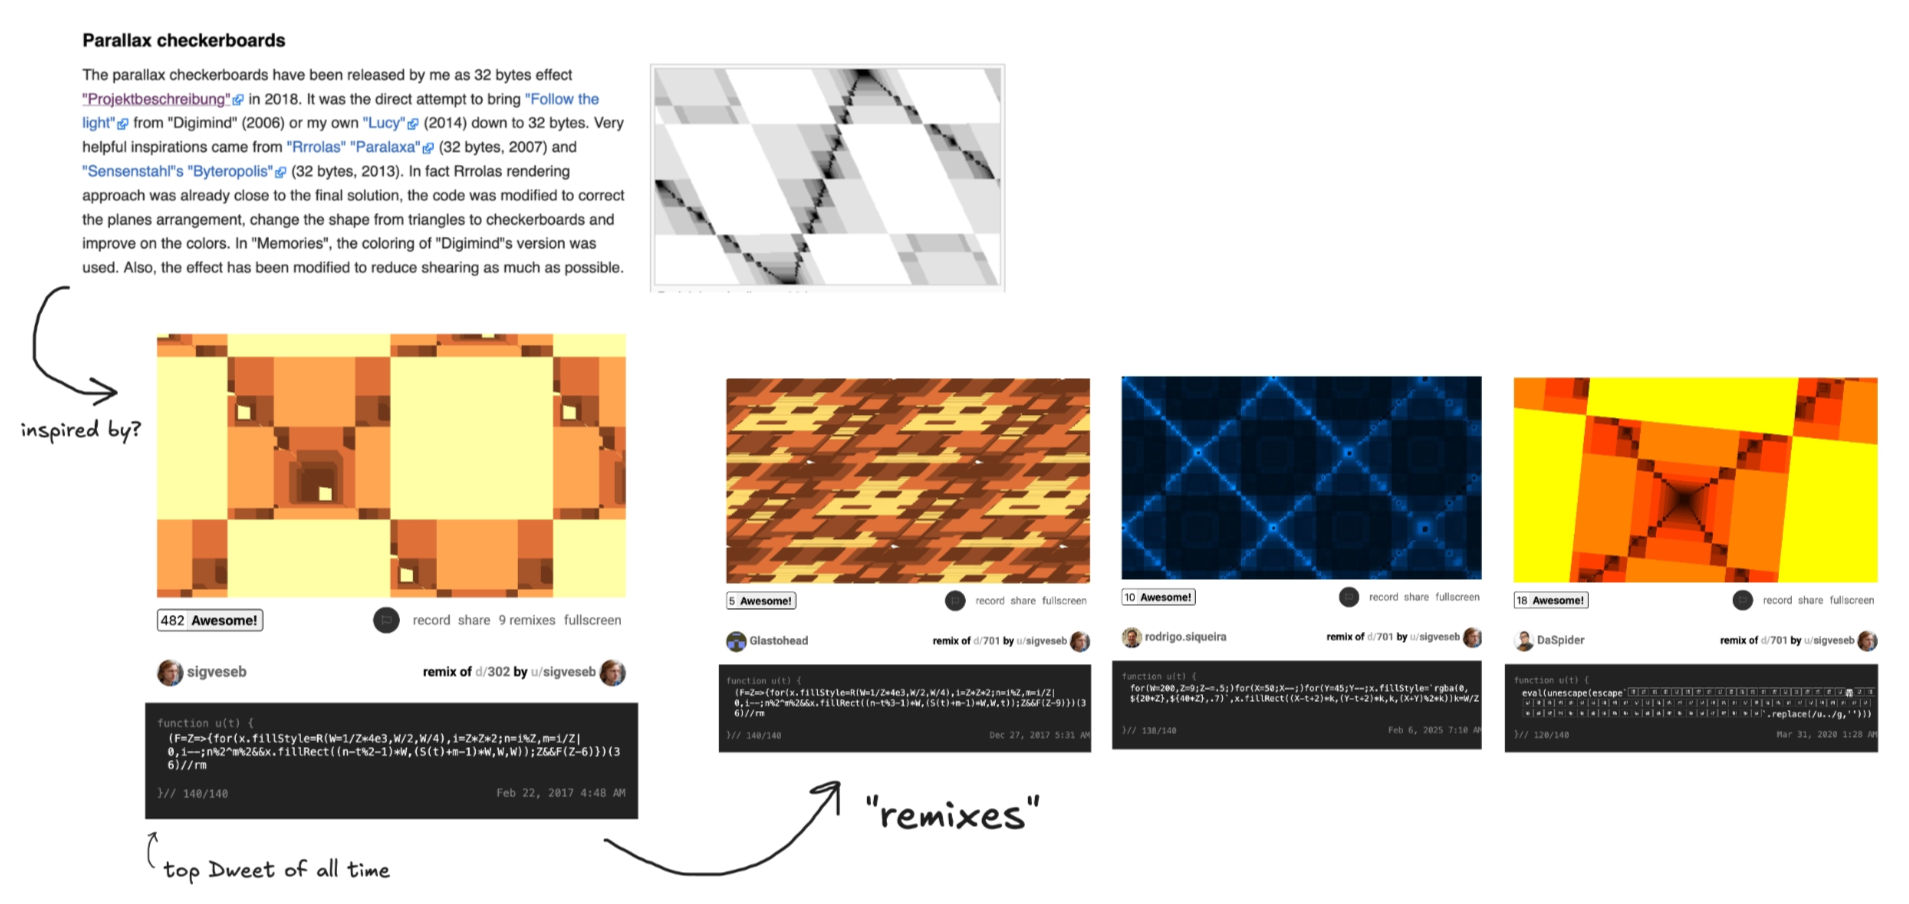
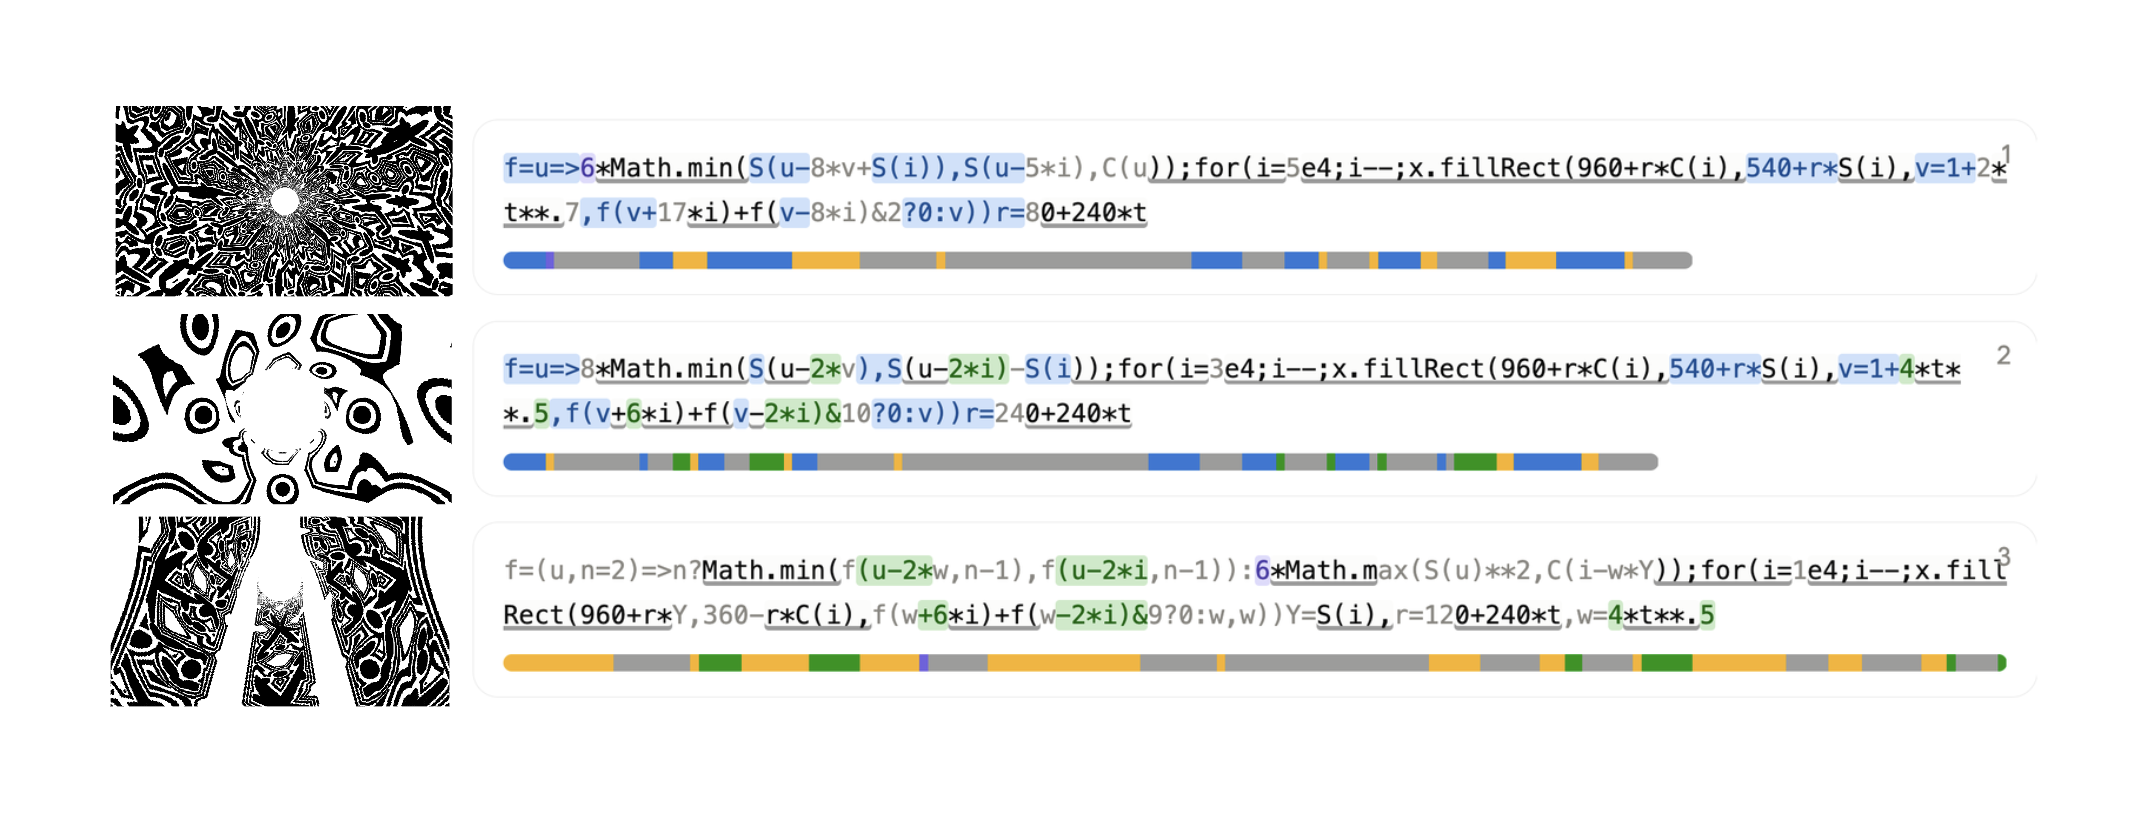
再深入探究后,我注意到,有些 remix 的源代码有大量重叠之处,仅有几个字符不同;另一些则通过完全不同的实现方式获得了相似的视觉效果。
这里有一个例子:我追溯了 d/36555 的来源,它来自 d/367547,而后者又衍生自 d/36467。灰色下划线的子字符串表示三者共有的部分。蓝色表示前两者共有的部分,绿色则表示后两者共有的部分。
在语言学中,语言具有生成性,即有限的词汇和有限的语法规则可以构成数量极其庞大的不同表达。编程语言也具有这一特性。现在来考虑前面提到的 Dweets。它们包含相互重叠的子字符串,但渲染结果却不同。假设你取一个 140 字符的程序,并删除其最后 30 个字符。即便假设字母表只有 64 个字符,也几乎可以组成 1.5 x 10^54 种可能的补全字符串。其中几乎所有字符串都会在语法上无效,或者产生乏味的结果。尽管如此,可能性的数量仍然大得难以想象。
人类不可能穷尽枚举所有可能性,而生成并测试所有可能的字符串也绝非明智之举。不过,部分程序后续内容的出现概率并不相同。
给定一个部分程序,某些字符和表达式出现在其后的可能性会明显高于其他字符和表达式。自回归语言模型的工作方式大致也是如此。我想知道,能否利用这样的模型来采样未完成 Dweet 的合理续写内容,并将每个程序可能发展的不同方向可视化。
然后,我就可以精准地删除某些子字符串,或者按照自己的审美偏好将它们混搭组合。
我也对自己在开始一个演示作品后将其“完成”的能力越来越沮丧,因此,一个能够理解 Dweeting 这种独特语言的自动补全工具,在我看来似乎是个相当诱人的方案。
大约在同一时期,我看到了 Mithil Vakde 的推文(你最近或许在 HackerNews 上见过他)。
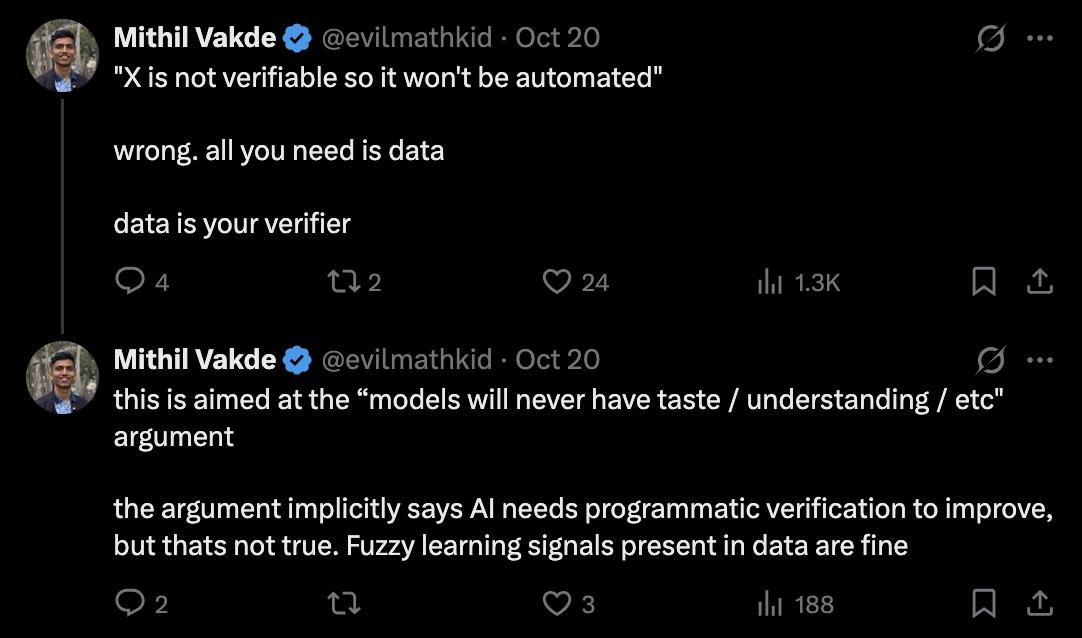
这又给了我一个尝试的理由——我能否把自己的审美品味作为先验注入我的自动补全模型?那真的太棒了。
我理解,没有人能写出一个函数来判断某个演示是否美观,但人们可以 表达自己的偏好——通过比较示例,对吧?
考虑到这一点,我决定把我的 GitHub Sponsors 收益用于租用 GPU,并后训练一个属于我自己的模型。
第一道障碍是找到合适的数据集。我最初尝试用 Claude Sonnet 5.5 生成合成的 Dweets,但发现它们完全不够赏心悦目。幸运的是,Dwitter.net 提供了一个 API,我利用它构建了一个包含 25k 条 Dweets 的小型数据集,用于训练,另有 ~1.3k 条作为验证集。
我以 Qwen2.5-Code-7B 为基础模型。在我测试的大多数 Dweets 上,它都难以完成补全;考虑到它们的语法十分独特,这是可以理解的。Dweets 大量使用代码高尔夫技巧和数学速记,这与通用编程模型通常接触到的代码相比相当不同。
我决定在这份语料库上尝试持续预训练(CPT),希望将模型的概率分布转向 dweeting 这种独特语言。为了确认是否奏效,我测量了训练前后各个 token 的惊讶度。惊讶度就是:在给定前面所有内容的情况下,模型赋予某个 token 的负对数概率。一个 token 越不可能,对模型而言就越令人意外。
在下图中,红色越深表示惊讶度越高。经过 CPT 后,大部分代码明显变得不再那么令人意外(尤其是那些不熟悉的编程惯用法)。
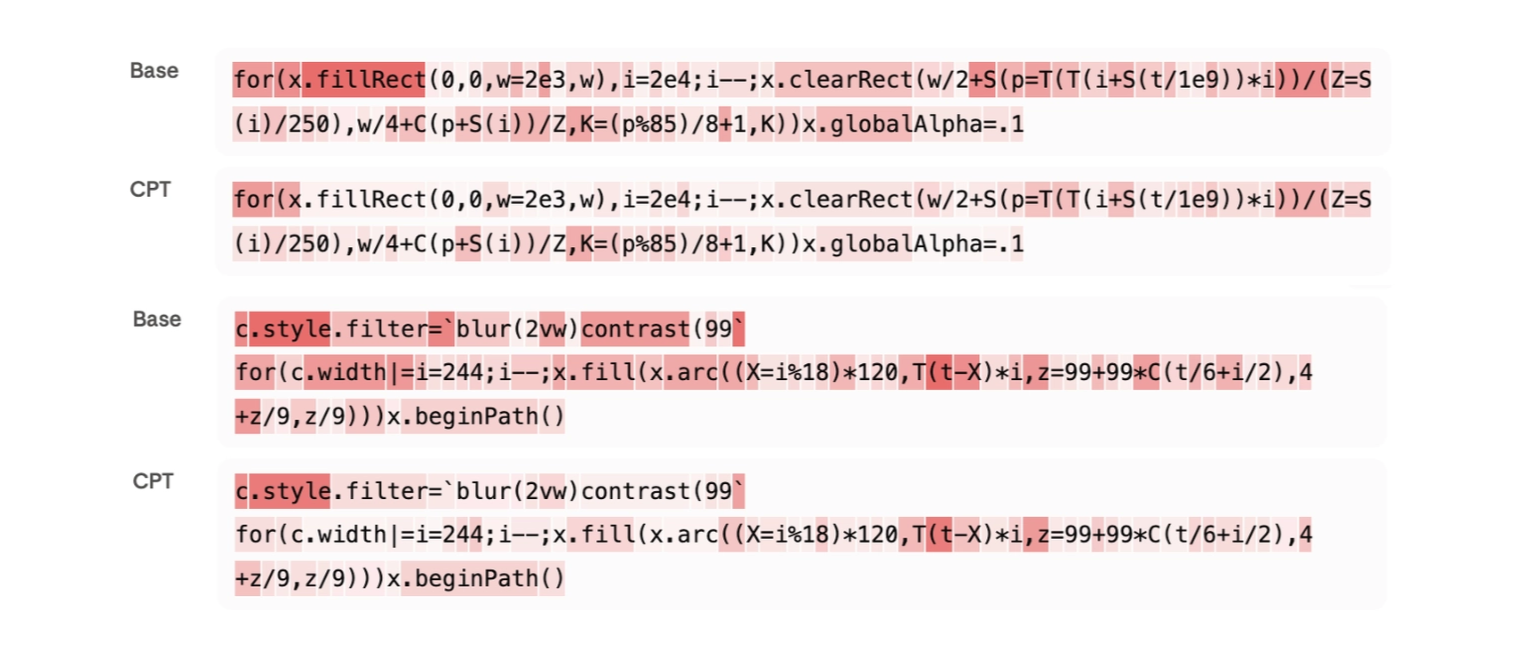
在 30 条留出的 Dweets 上,困惑度从 28.63 降至 8.57,这意味着模型在预测这些小巧古怪程序的结构方面已经显著做得更好。
虽然生成的程序更加一致,但仍然缺少某种“魅力”。幸运的是,Dwitter 为每条 Dweet 都提供了一个“精彩度”评分。我决定用它来构建一套课程安排。
我按照“精彩度”评分对前 5k 条 Dweets 进行排名,并构建了一套逐步偏向更受认可程序的课程安排。起初,每条 Dweet 被采样的概率相同。在 400 个训练步骤中,我逐步提高分配给排名更高的程序的权重,直到前 1000 条占据约 67% 的采样概率。
| 排名区间 | 步骤 1 | 步骤 100 | 步骤 200 | 步骤 300 | 步骤 400 |
|---|---|---|---|---|---|
| 1-1000 | 20.00% | 35.89% | 48.74% | 59.01% | 67.23% |
| 1001-2000 | 20.00% | 27.97% | 29.60% | 28.01% | 24.99% |
| 2001-3000 | 20.00% | 20.03% | 15.23% | 10.41% | 6.75% |
| 3001-4000 | 20.00% | 12.06% | 5.63% | 2.41% | 0.99% |
| 4001-5000 | 20.00% | 4.05% | 0.81% | 0.16% | 0.03% |
结果证明,这确实是一个突破!生成的续写在视觉上有趣得多。
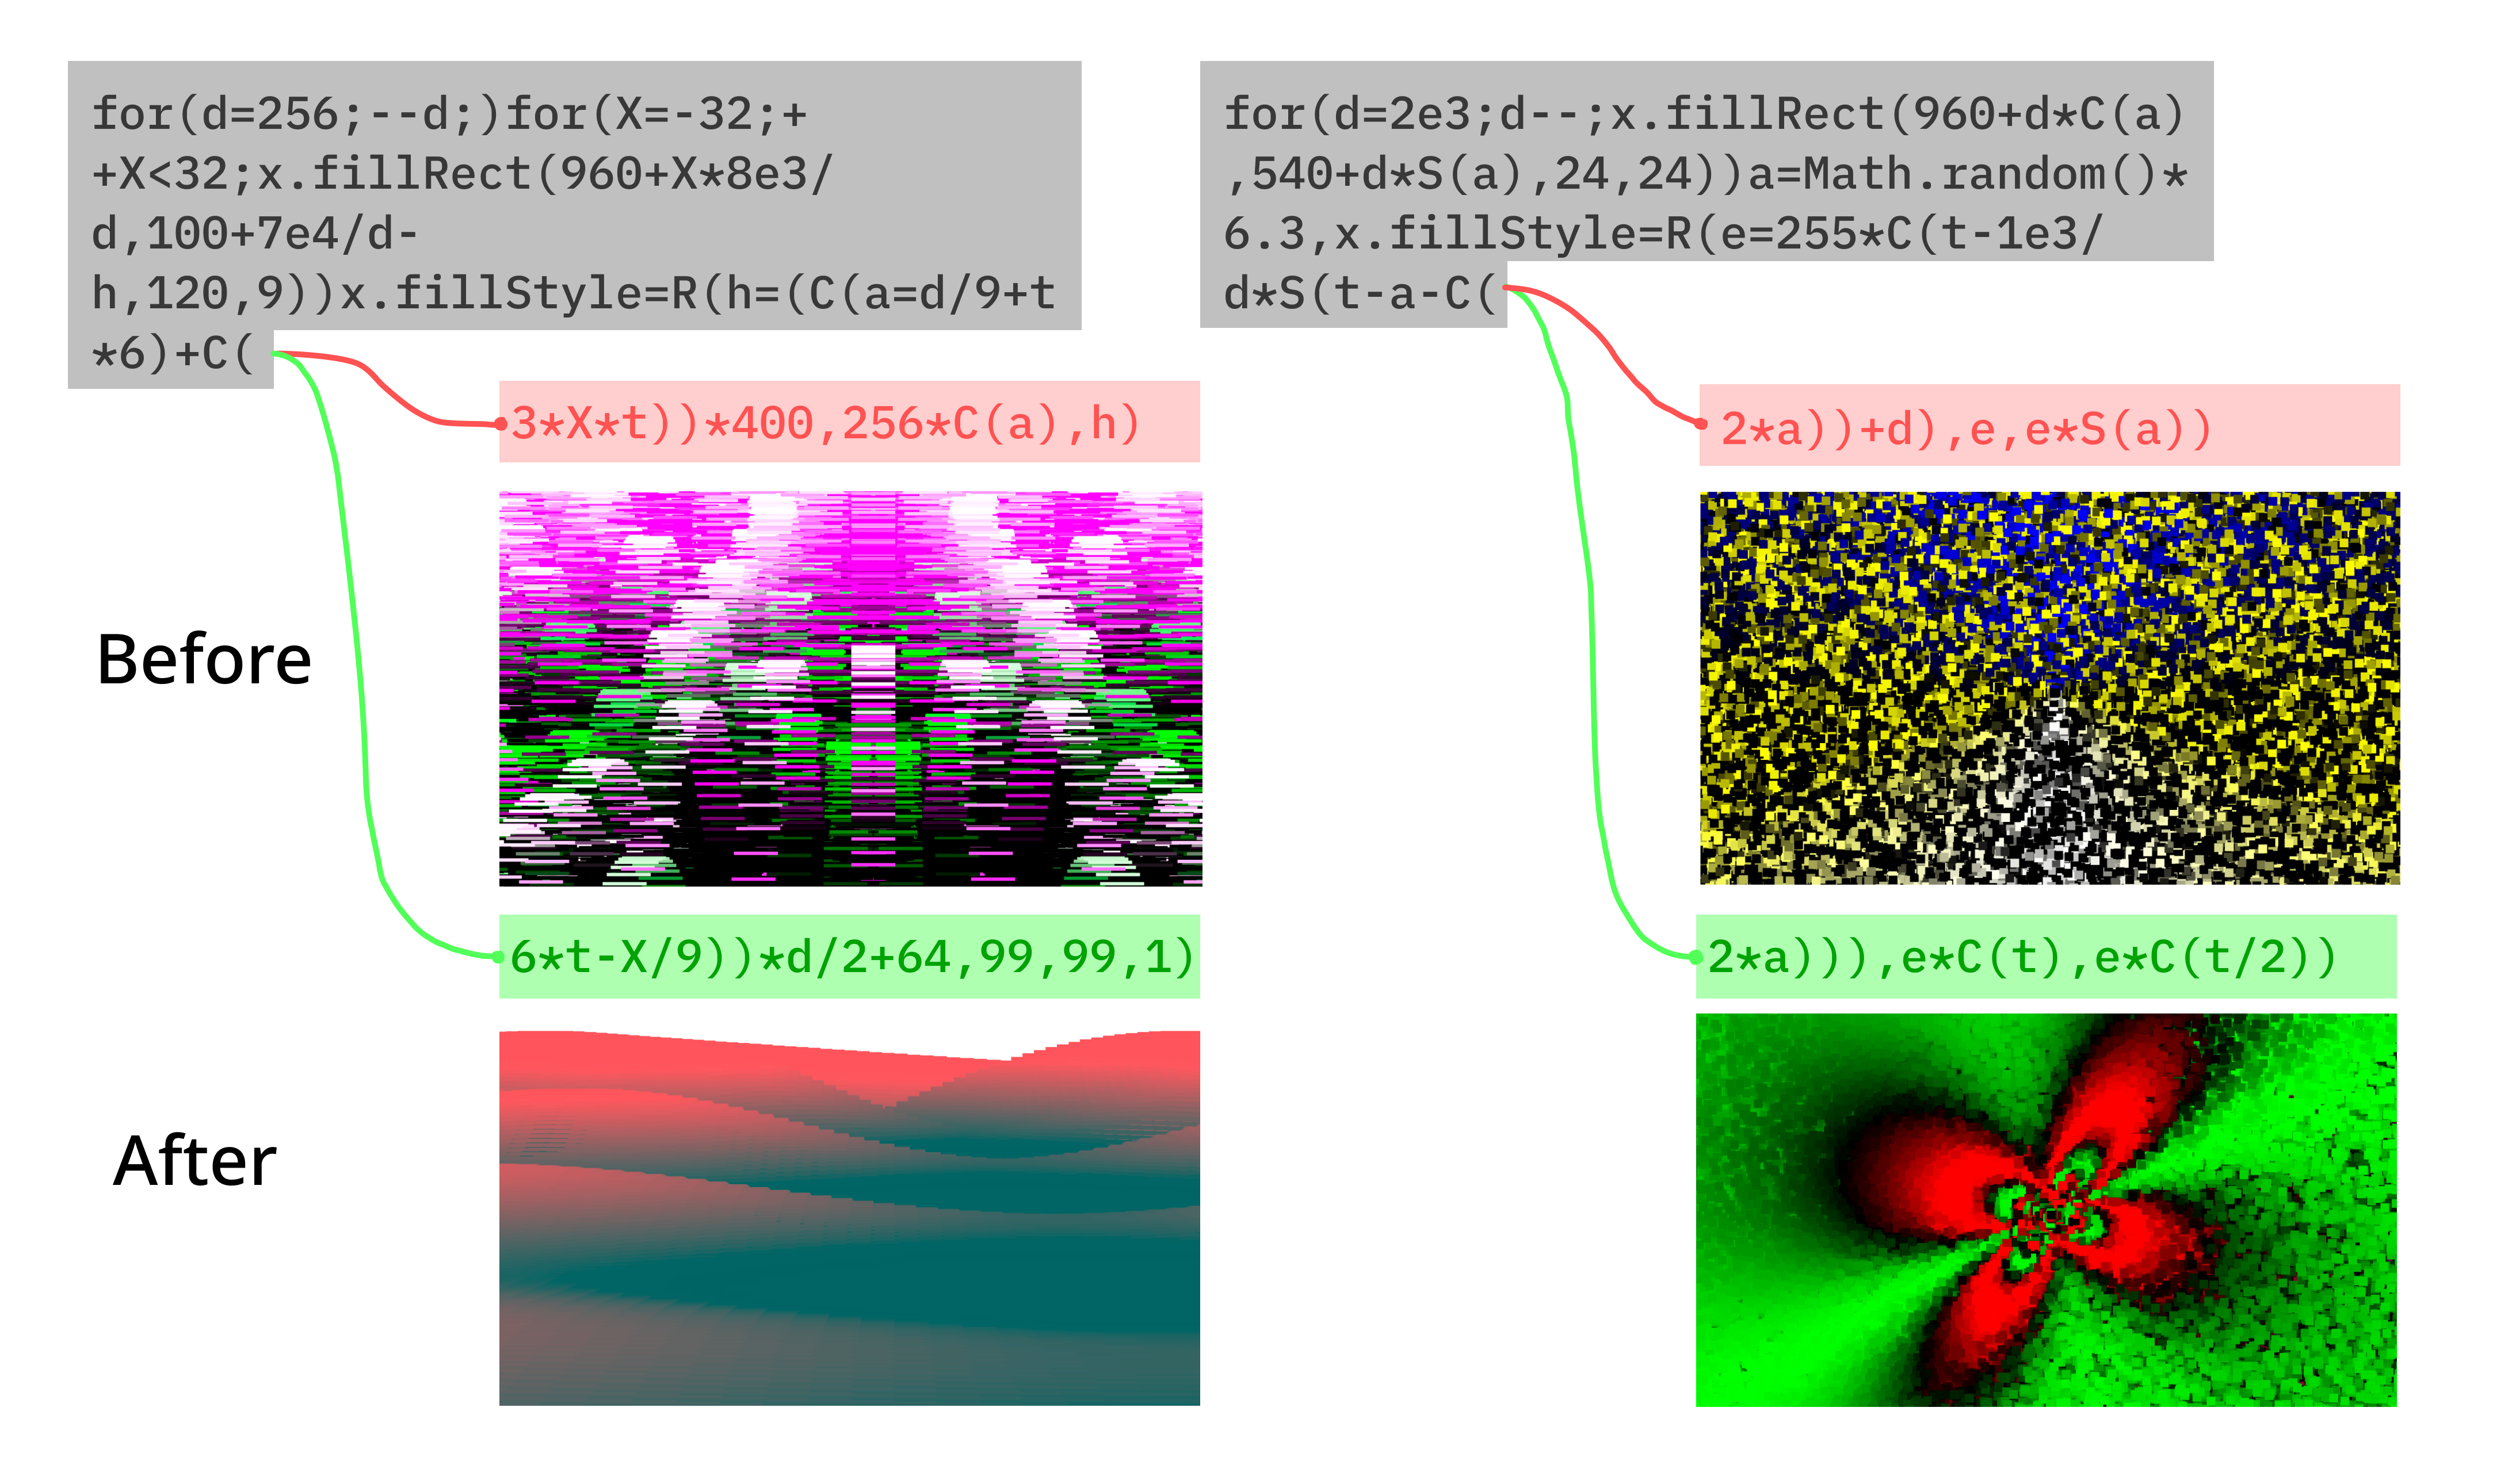
有意思的是,token 似然的提升甚至延伸到了课程训练期间从未被采样过的 Dweets。困惑度从 7.42 降至 5.65,尽管增益在各精彩度排名之间分布得相当均匀。
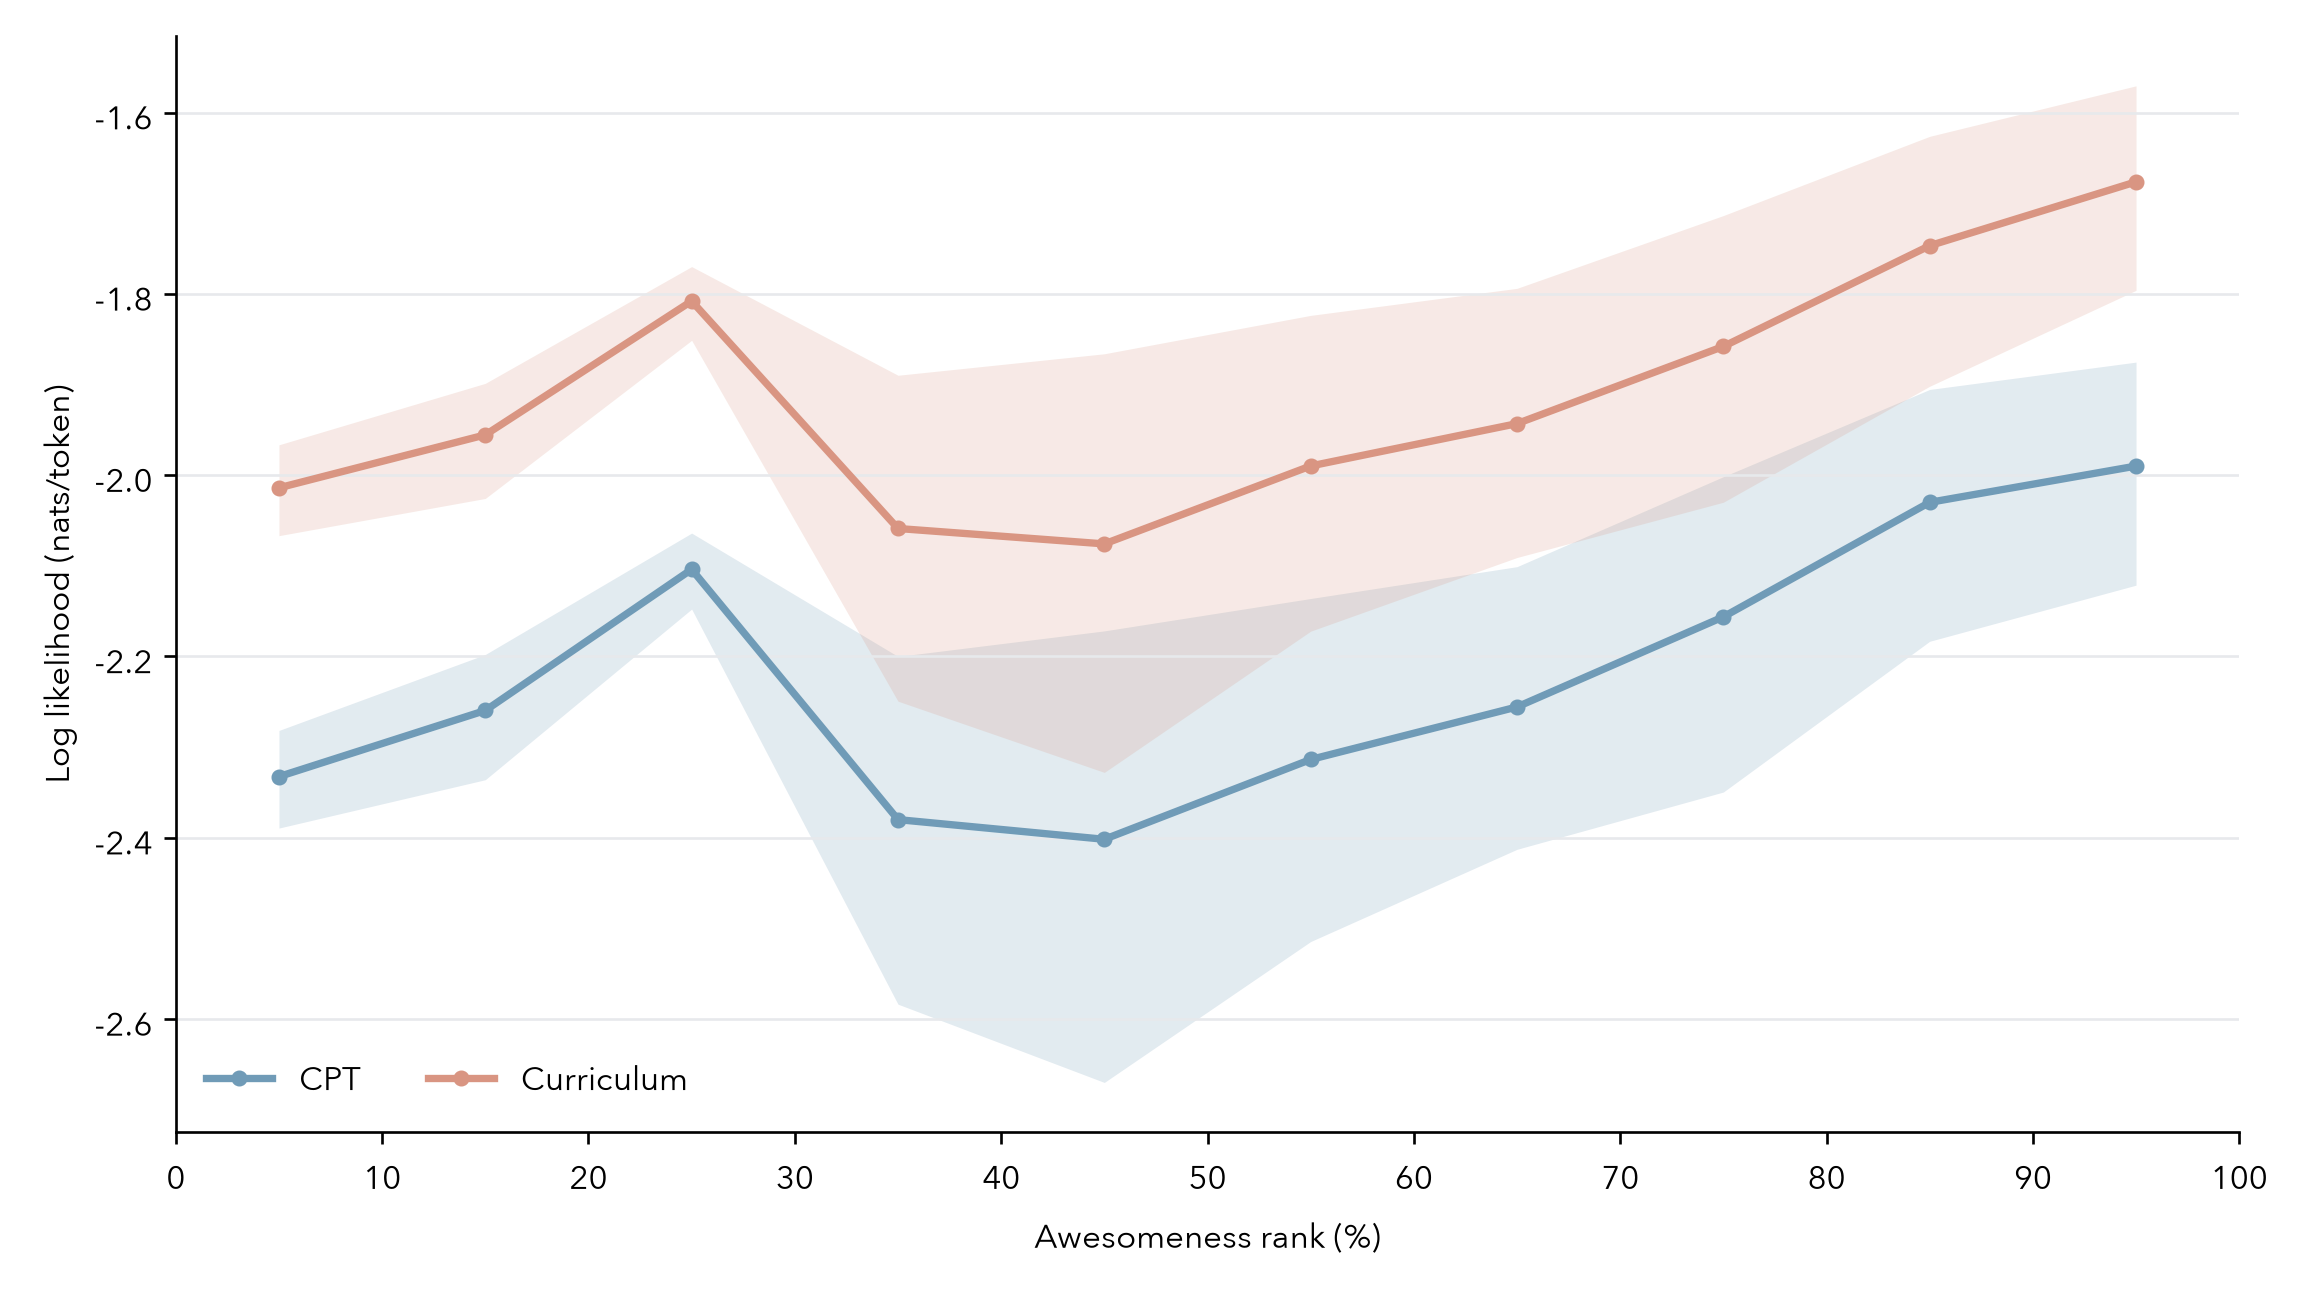
在 7000 条 Dweets 上,课程训练提升了所有精彩度排名档位的 token 似然,包括训练期间从未被采样的程序。对于原始模型认为困难的程序,提升尤其明显。
现在,我拥有了一个能够生成相当优美的续写的模型。我不知道自己能否纳入个人审美偏好,让它再进一步。
九月中旬,我偶然看到 Surya 撰写的用代码训练 AI 绘画一文,他们利用 RL 让 p5js 生成水彩画。他们尝试了不同的奖励函数,最终采用与一组人工评分画作进行成对比较的方式。我记下了这个想法,觉得可以用 Demoscener 尝试类似做法(反复称它为“这个模型”总让我觉得不太对劲)。
我选择使用 GRPO 进行 RLHF,由我自己充当奖励函数。
对于每篇未完成的 Dweet,我会采样一组 8 个补全结果,将它们并排渲染,再选出其中我认为最有美学韵味的一个。如果没有一个合我的心意,我就跳过这一组。我用这些偏好更新 Demoscener 的策略,然后采样新的续写,以每轮 500 组的方式重复整个过程大约 9–10 轮。总的来说,我人工查看了约 40,000 个动画。
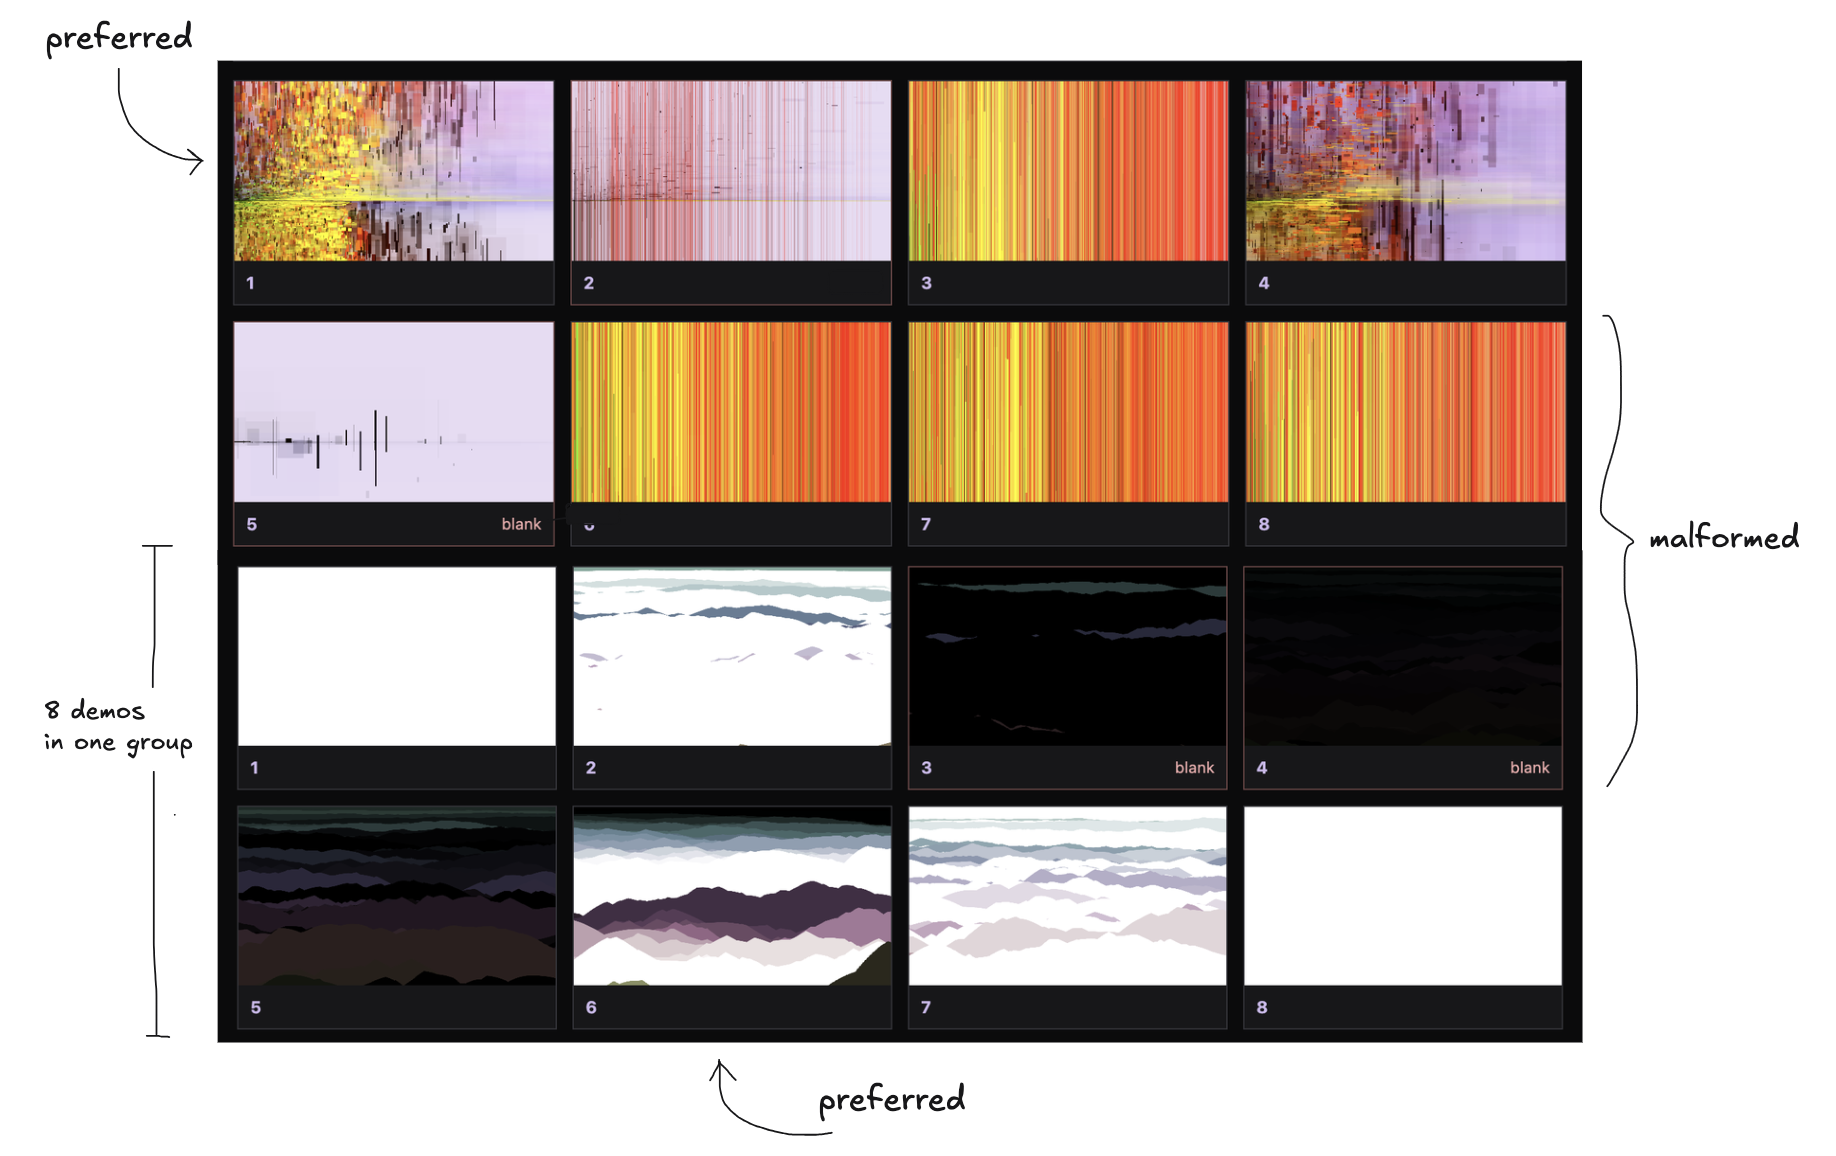
大约到了第 10,000 个动画时,我才开始意识到 VLM 和 HPSv3 的价值。遗憾的是,已经太晚了。
经过几轮训练后,我想看看自己的审美究竟在多大程度上影响了 Demoscener。我请了一位极不情愿的朋友来评判来自几个检查点的 400 组演示(我随机选了 4 个),并且不让他知道每组演示是由哪个模型生成的。
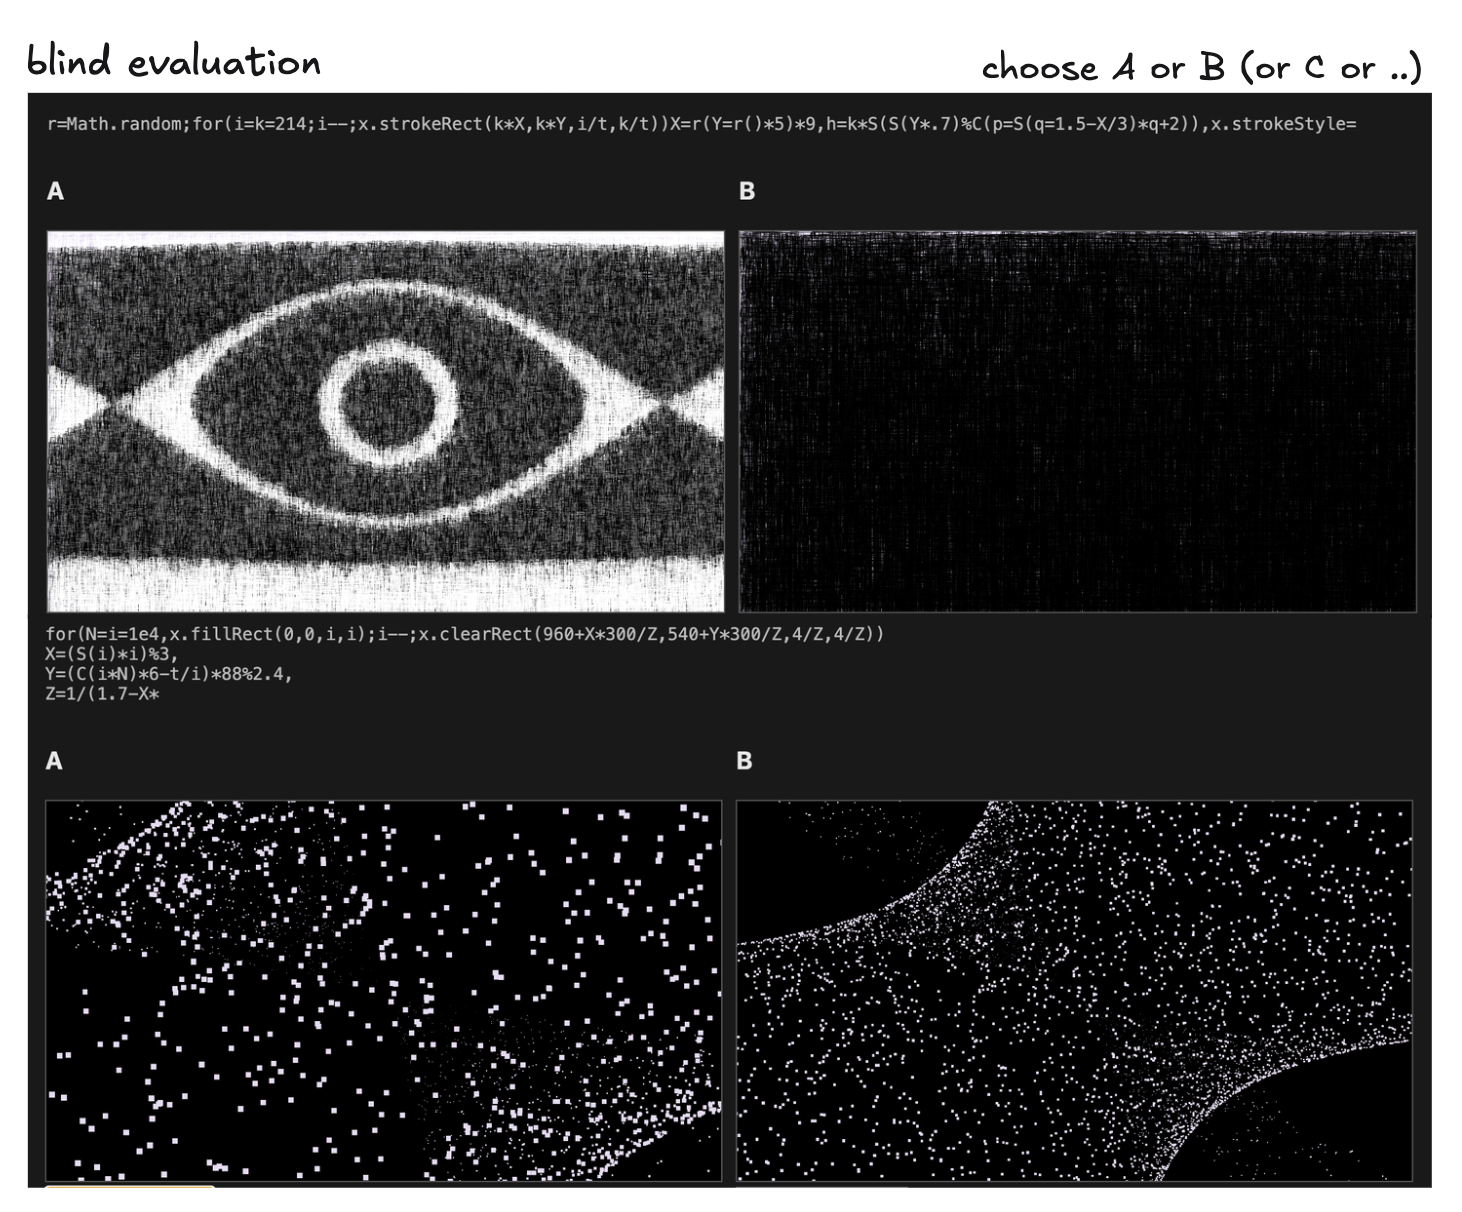
结果表明,检查点 4 获得的评价最高,因此我用它在 Mac 上运行推理。
如今,这个支线任务接近尾声。我搭建了一个小界面,可以从同一个前缀生成多个续写,将它们并排渲染,再从其中最合我心意的那个分叉。我还可以随后调整代码、生成更多续写,并继续探索。
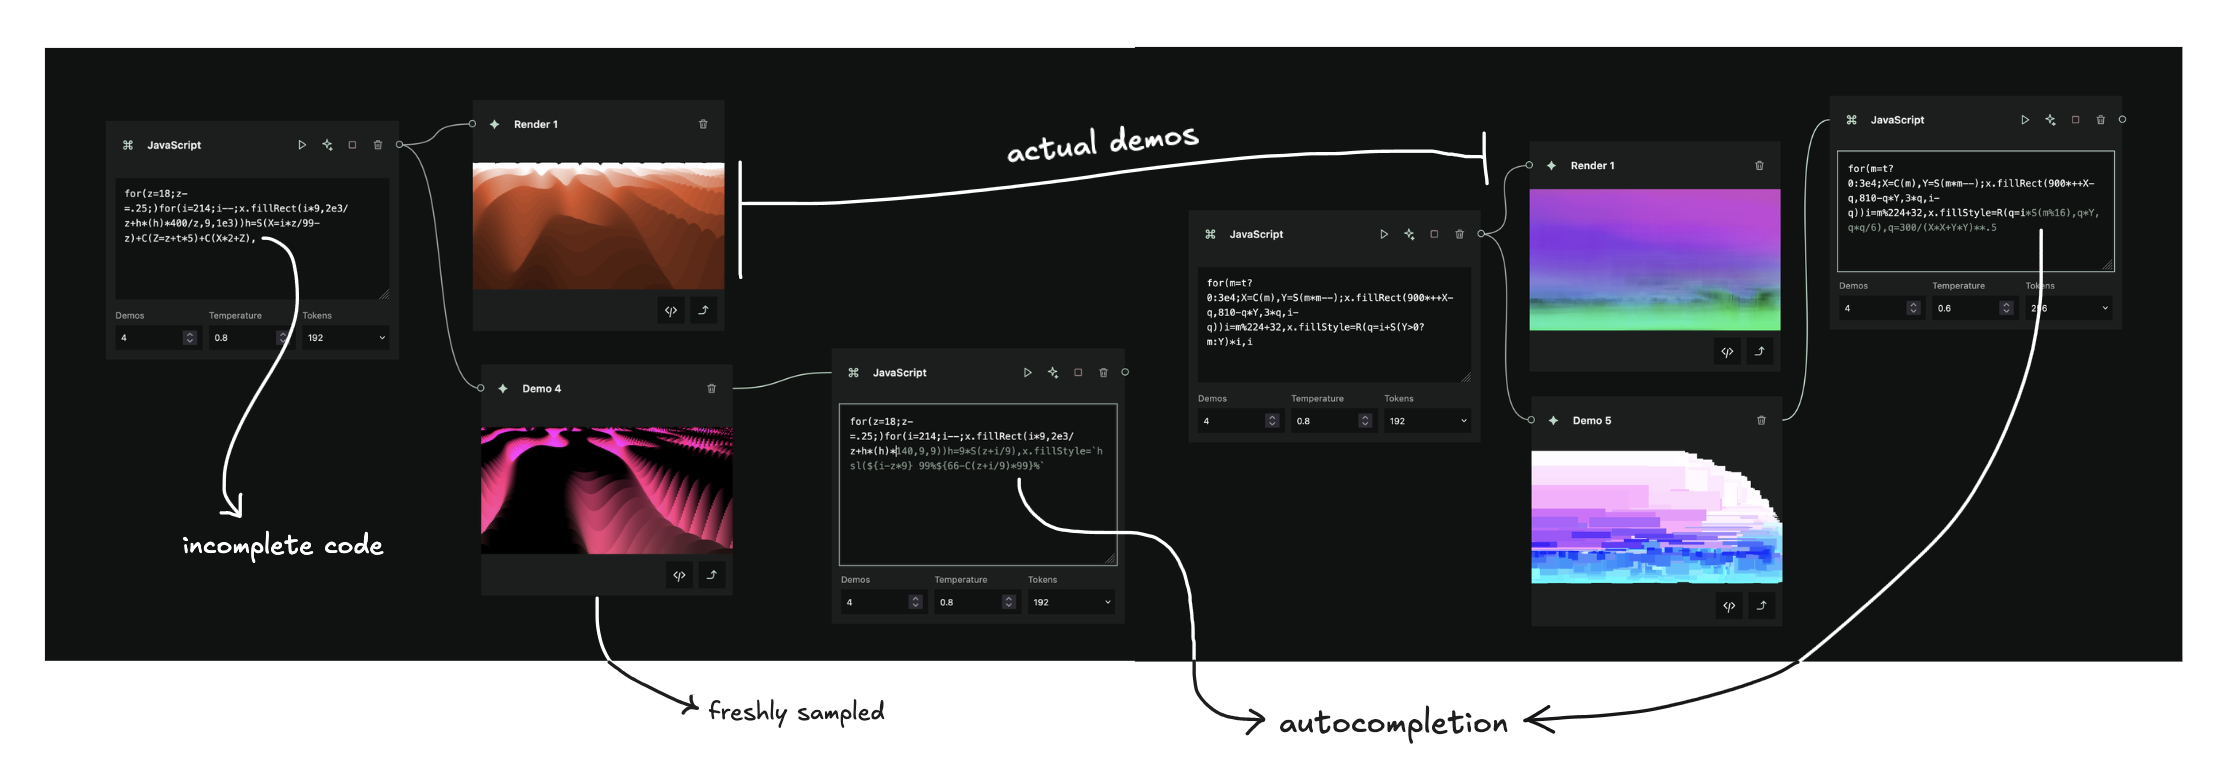
每条分支都代表一种可能的续写,我可以对其进行直观比较、手动微调,并将其作为进一步探索的起点。
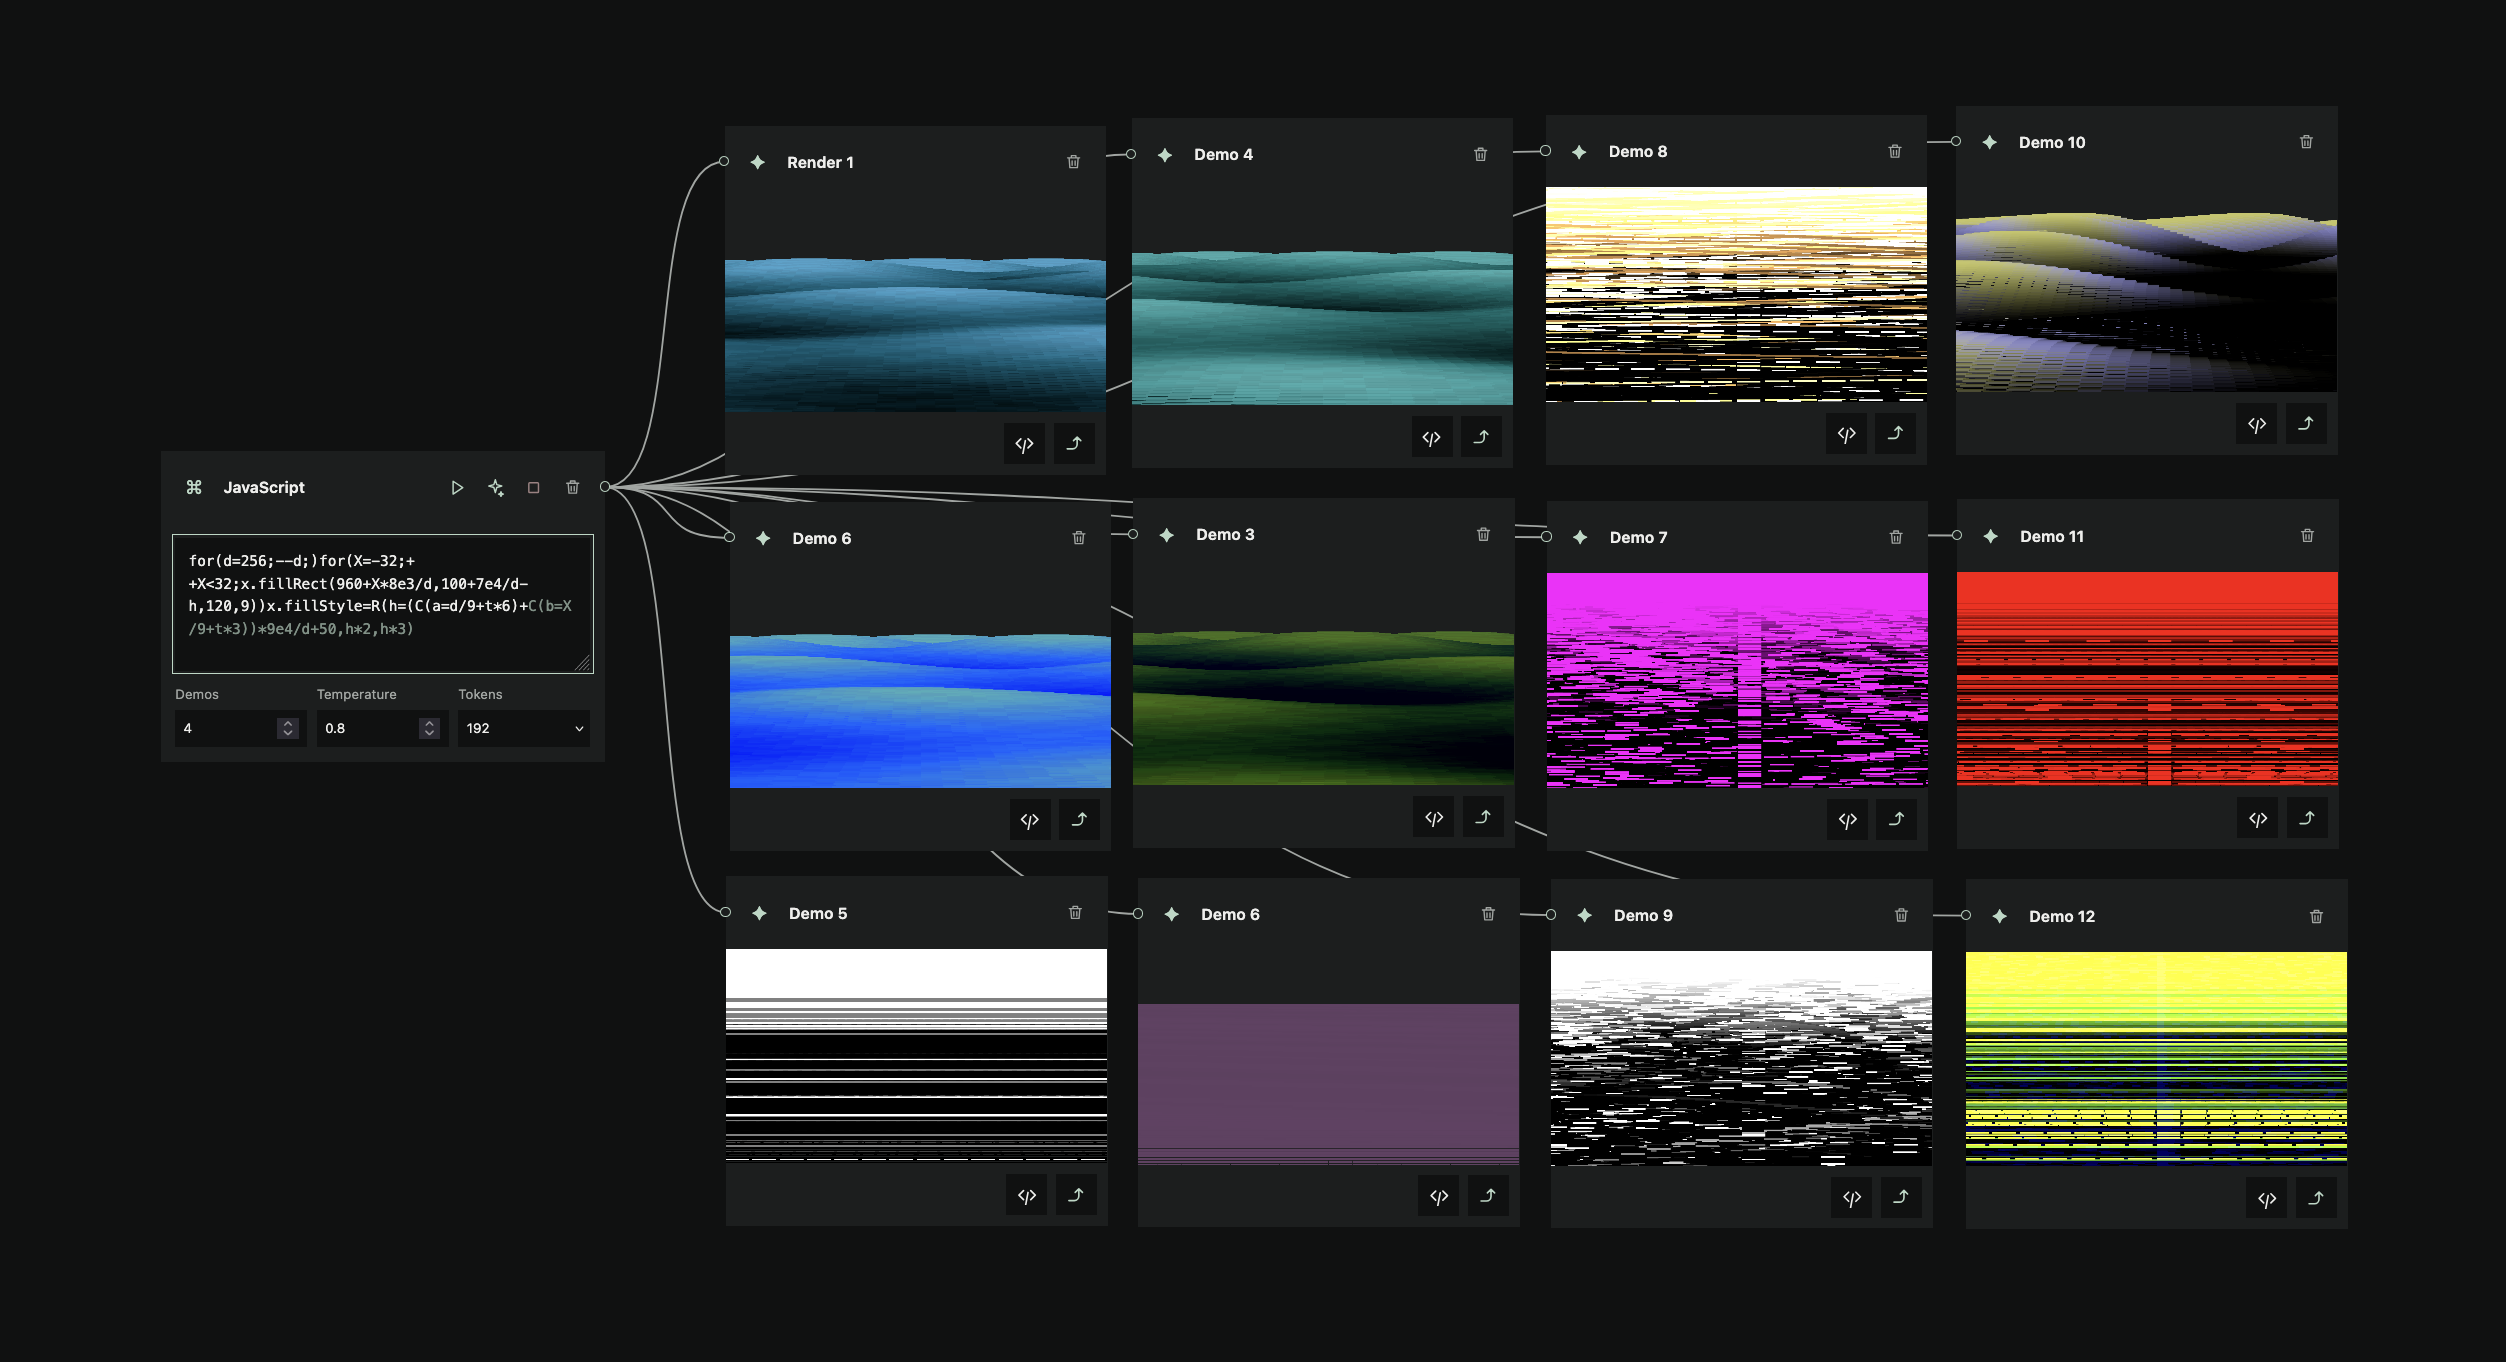
能够徜徉于这些可能性之间,有一种很美妙的感觉。我想我还会多花些时间这样做。
你可以在 HuggingFace 上找到Demoscener-7B和数据集。
来源:Hacker News · datavorous.com