Jane Street 通过索引与自适应切分扩展并基准测试 Aria 消息总线
Scaling and benchmarking a critical message bus using a new indexing strategy
Jane Street 实习生通过为内部消息总线 Aria 引入按主题分区的索引和自适应子树切分,把 tip 恢复的 CPU 使用率在生产环境降低了约 30%,并消除了部分服务器的尾部延迟。
给出了关键消息总线在生产环境中用索引与自适应切分做扩展的完整案例,以及用 AI 智能体跑多种实现做基准测试的具体做法。
以下是 2026 年暑期实习生项目系列文章的一部分——更多内容请参阅"实习生的成果,特大 2026 年版"
Aria 是我们的内部消息传递框架和托管系统,每天处理数 TB 的数据。客户端可以订阅 Aria 以获取实时消息流。随着公司内部 Aria 使用量的快速增长,我们必须寻找更多机会来优化和重新架构系统,使其能够随着数据量和吞吐量的增加而扩展。在 Aria 团队实习的 Theodor Totev 今年夏天的重点是使用索引和树分割来改进一个特定的用例:如何让客户端以更低的成本读取消息的子集?他的优化在运行生产工作负载时实现了 CPU 使用率降低 30%,同时保持了这一关键系统所需的极高正确性标准。
消息过滤使我们的服务器不堪重负
当 Aria 通过 TCP 向客户端传递消息时,它会将最近的流(我们称之为 流尖)保存在内存中的环形缓冲区里。如果客户端落后了,它可以请求该环形缓冲区中的最近消息以保持最新。我们将这个过程称为 流尖恢复。
流尖恢复的一个挑战在于,Aria 存储的是完整的消息流,而客户端通常只关心其中一小部分消息。Aria 将消息流划分为 主题,它们形成了一个类似文件系统的分层命名空间。客户端可以订阅单个主题或主题子树,主题子树由给定主题下的所有主题组成,类似于 globstar。Aria 从整个流中过滤出已订阅主题的消息,并将这些消息传递给客户端。
最初,我们通过简单的线性扫描来进行过滤是没有问题的,因为虽然算法效率不高,但对流的循环访问对 CPU 缓存友好,因此速度尚可。然而,随着进行流尖恢复的客户端数量增加,我们注意到服务器在应对不断增长的负载时开始捉襟见肘。一些服务器的 CPU 利用率达到了 100%,导致客户端"从流尖掉队"而无法追赶上来。我们增加了更多服务器作为临时解决方案,但很明显,我们迫切需要重新思考流尖恢复的代码。
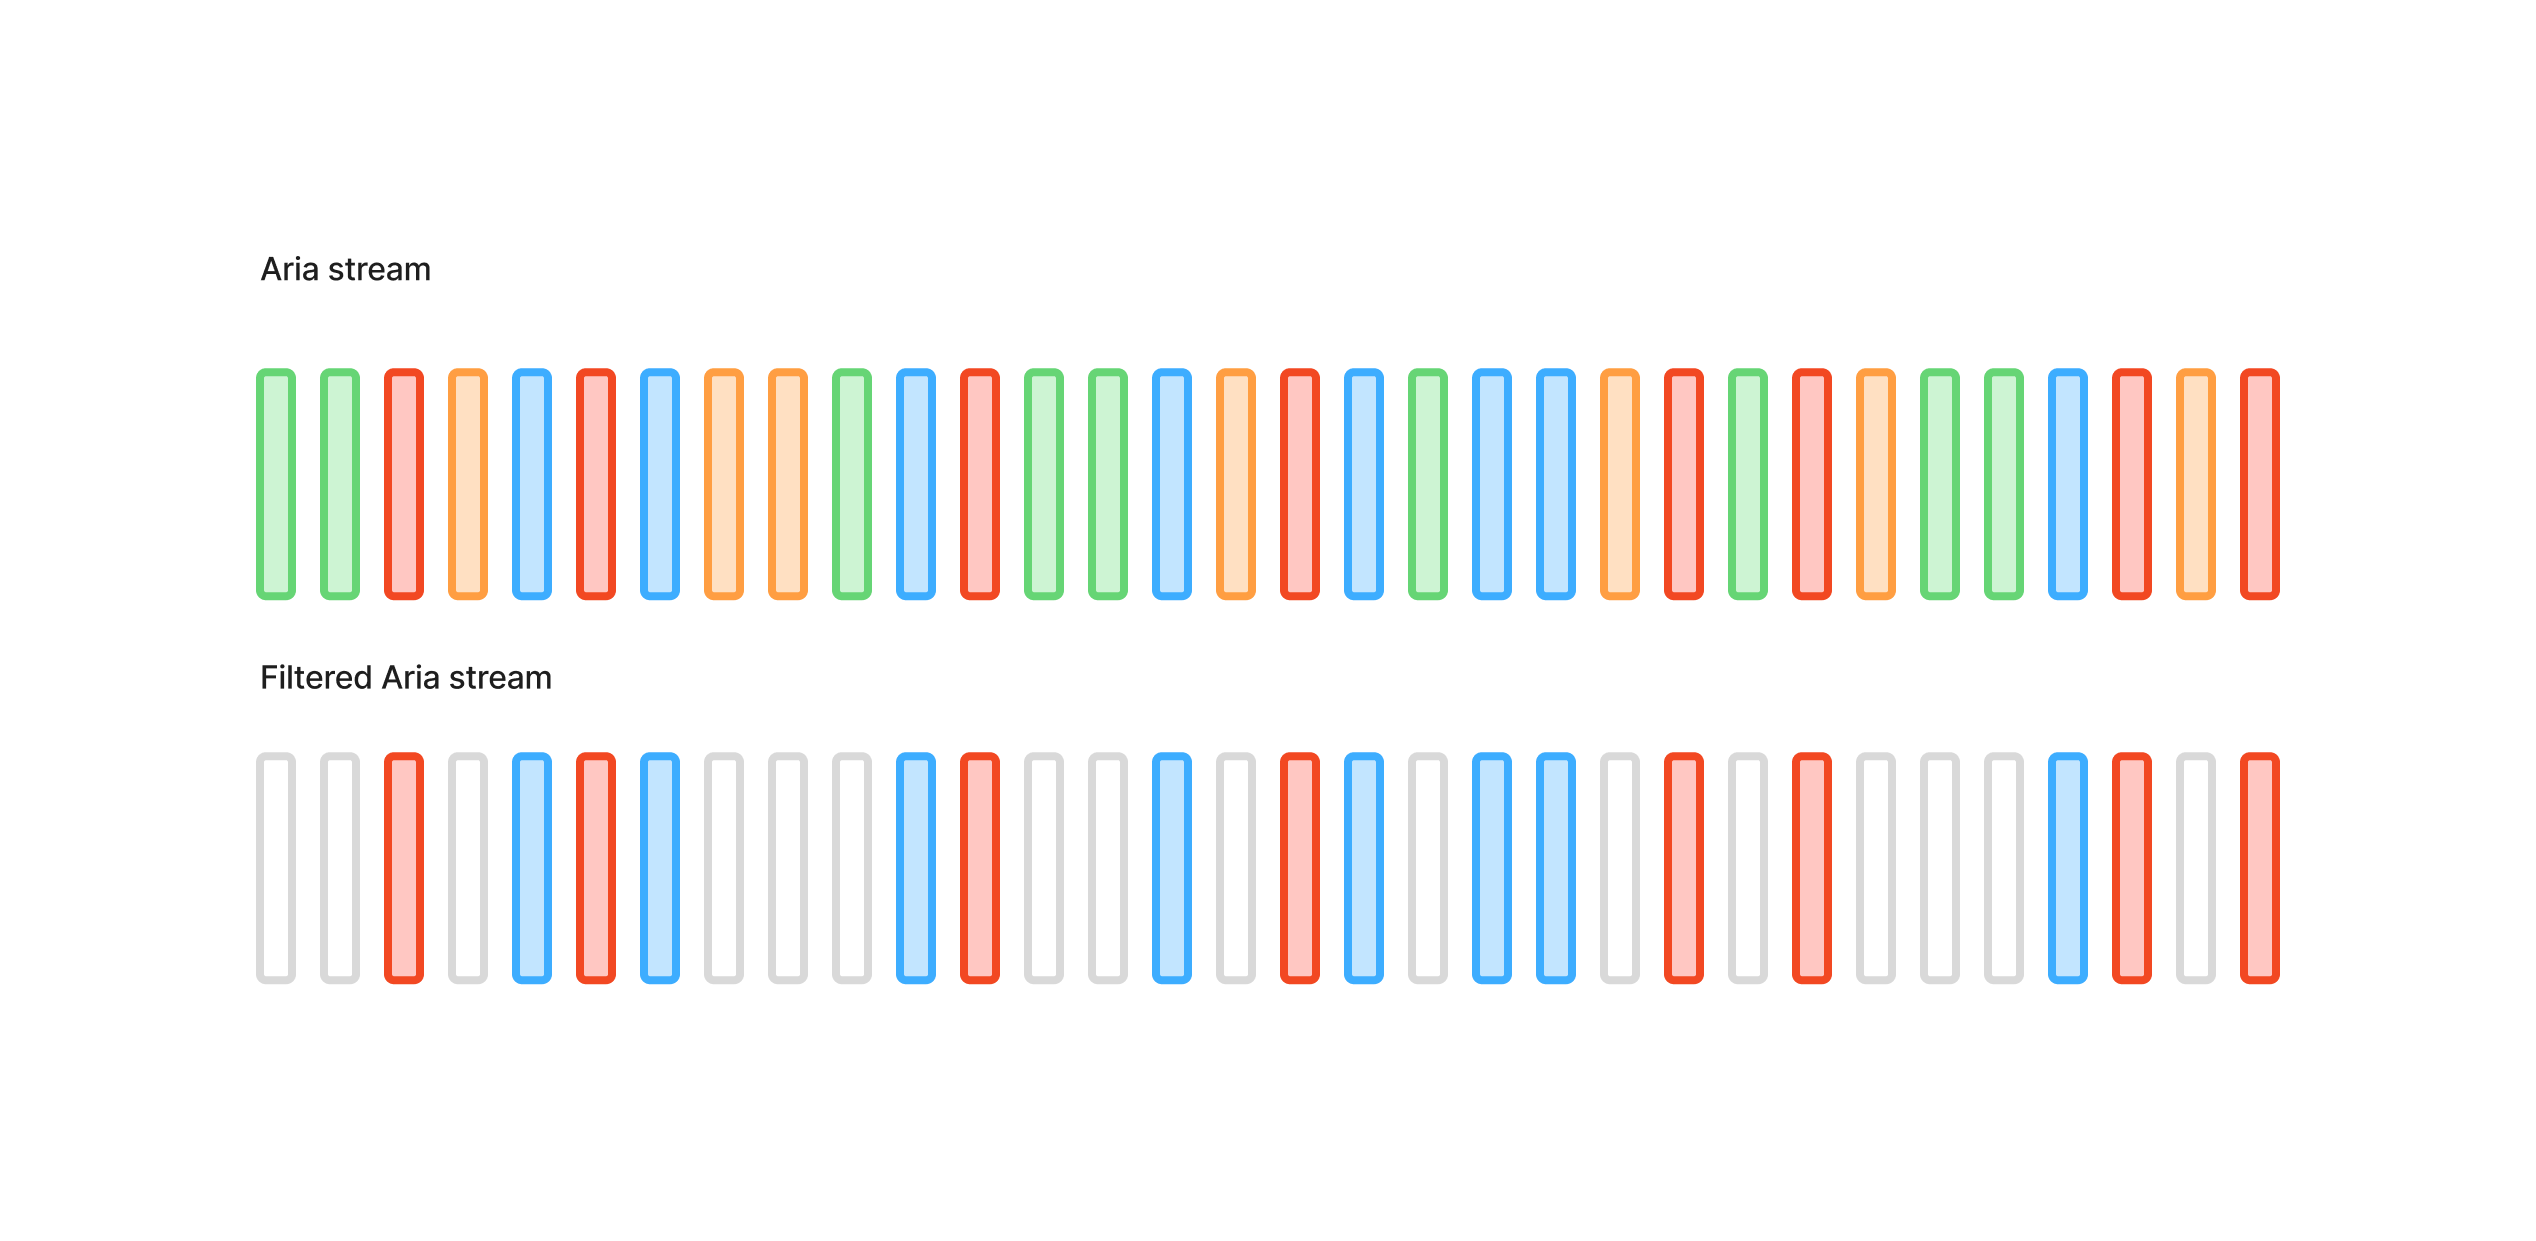
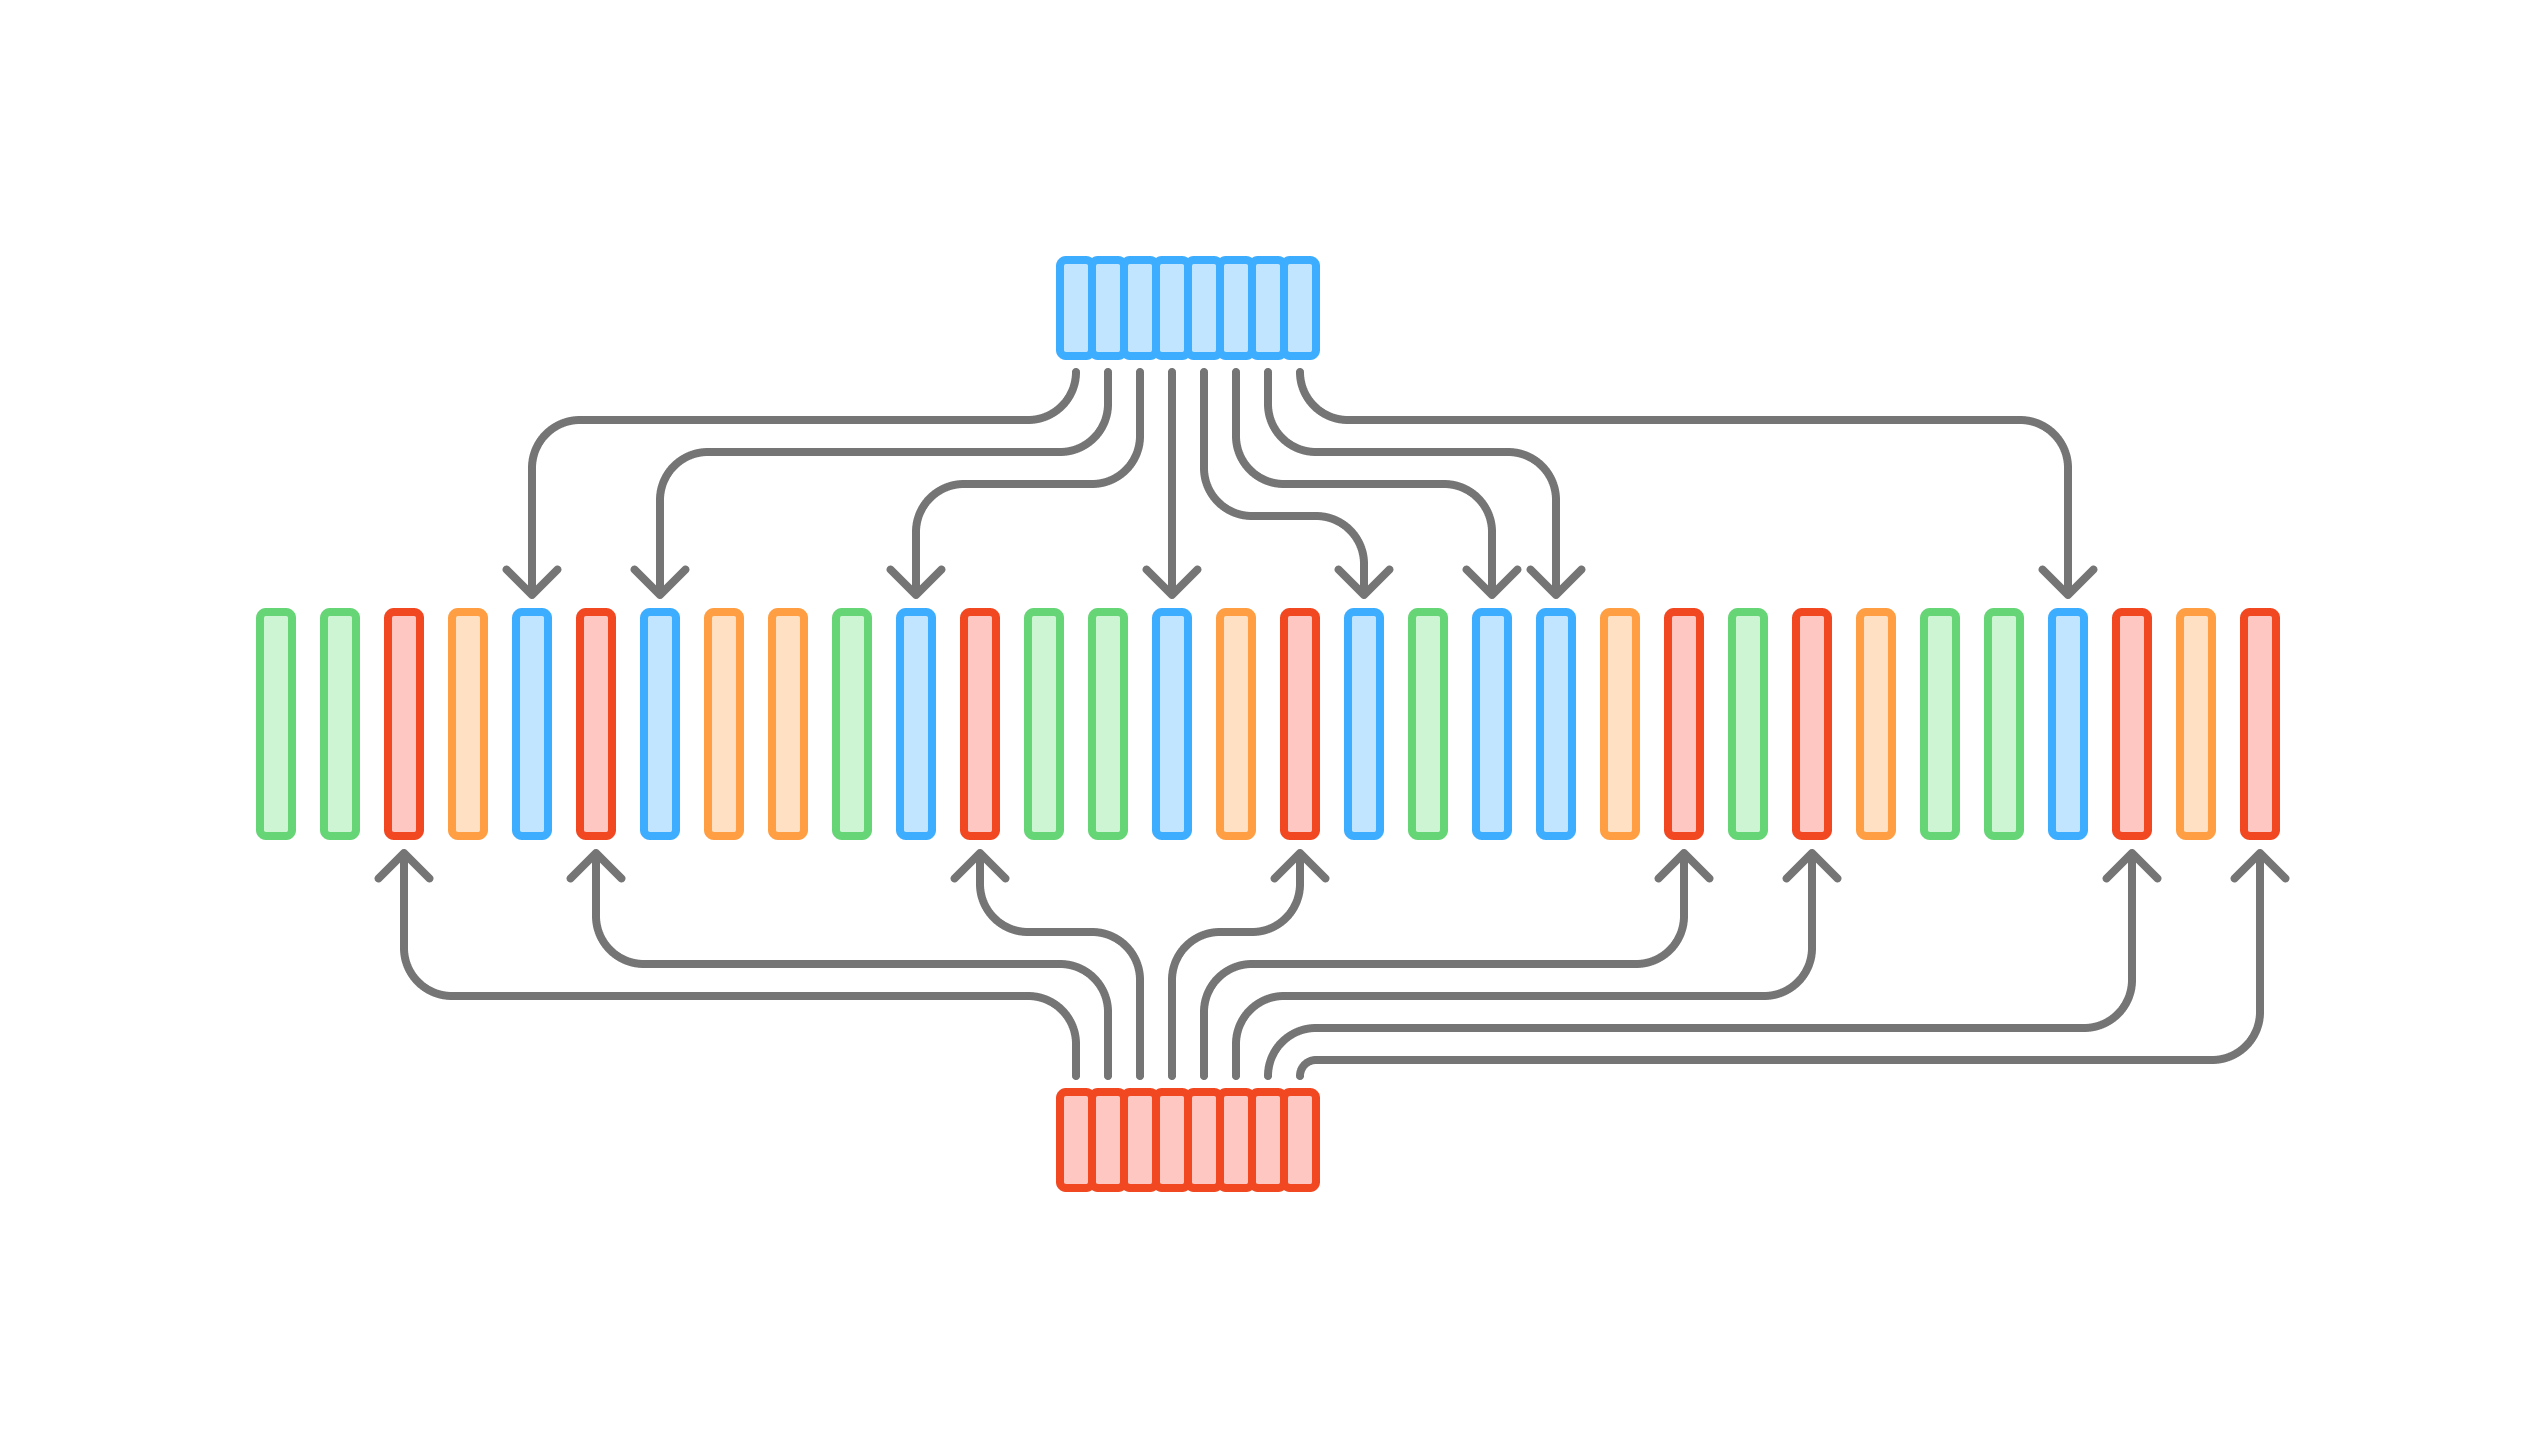
Theodor 决定通过添加 Aria 可用于高效过滤消息流中的消息的索引数据结构来解决这个问题。但应该索引什么呢?一种天真的做法是为每个主题建立索引。然而,Aria 实例可以拥有近一百万个主题,这种方法是不可行的。Theodor 转而为每个 主题分区创建索引。主题分区由具有相同两段前缀的所有主题组成,其中段是由斜杠分隔的主题名称的单个部分。例如,app/codestore/commits 和 app/codestore/features 都属于 app/codestore 主题分区。
每个主题分区都会获得一个索引,记录其消息在 Aria 流中的位置:
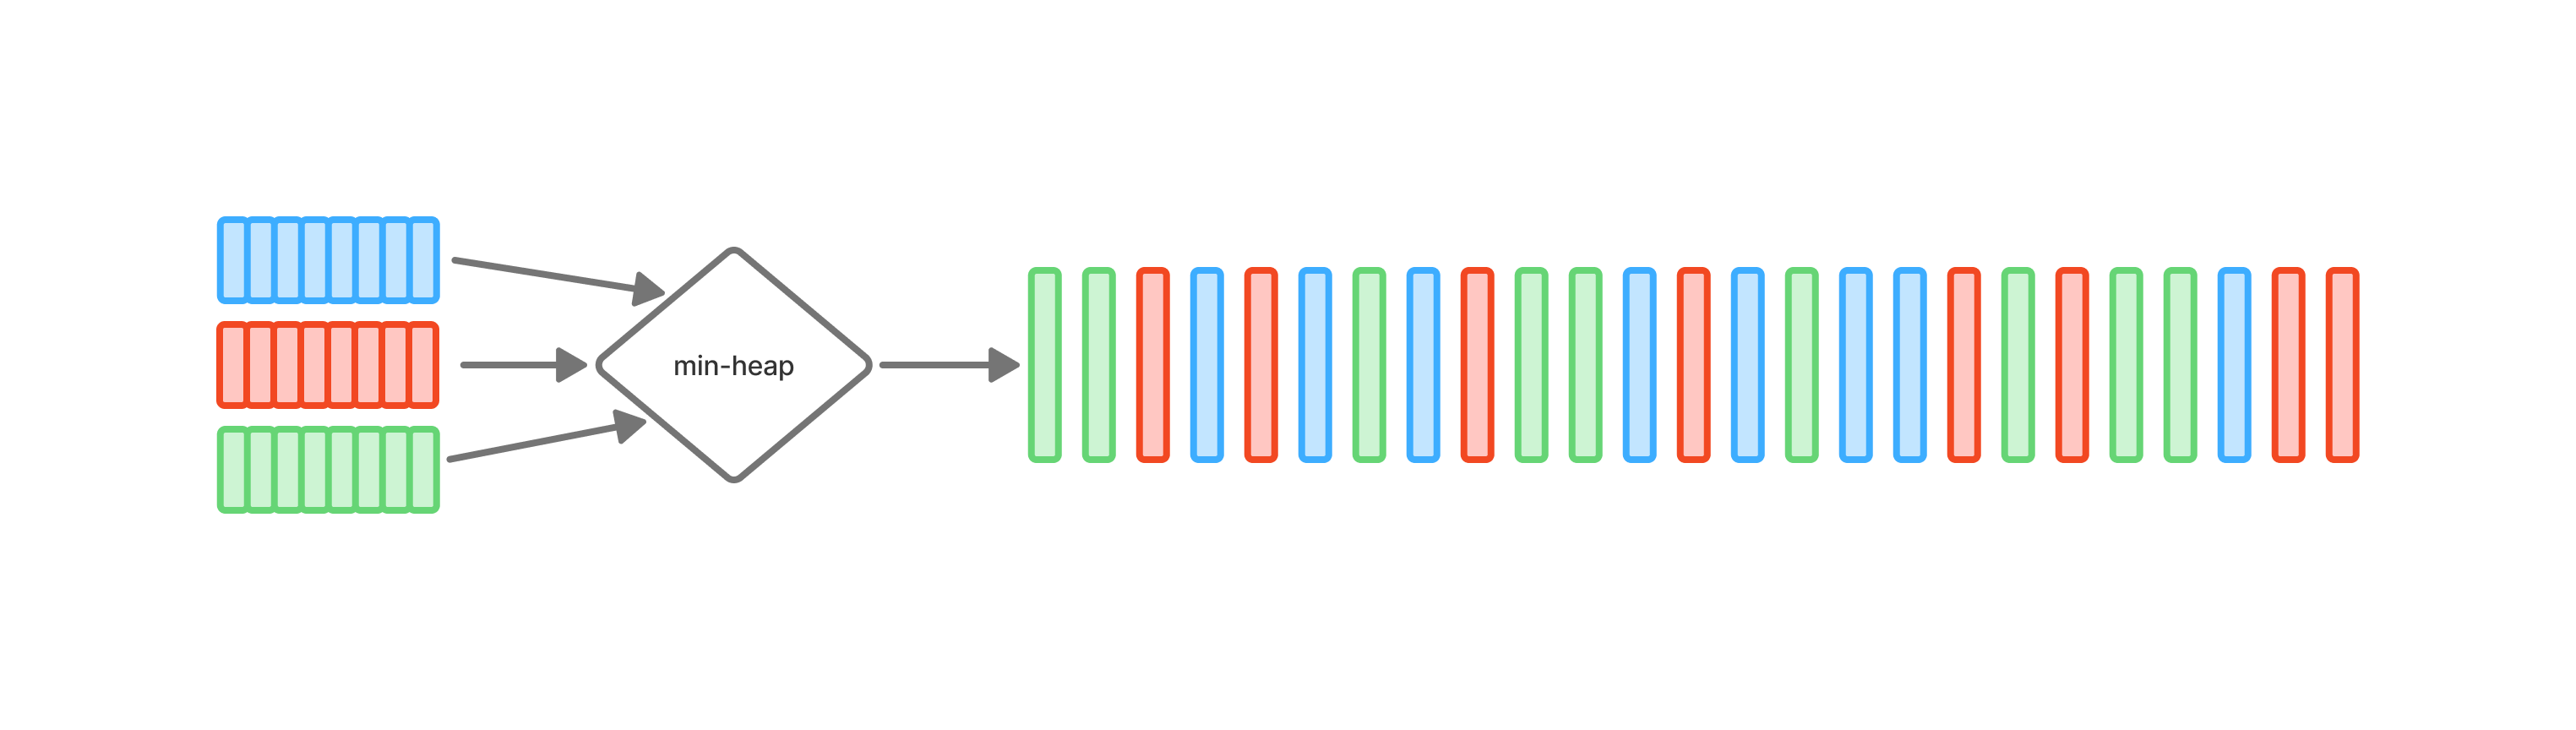
当客户端请求消息时,Aria 使用最小堆对索引进行 n 路合并。这使得 Aria 能够仅针对这些特定的主题分区,高效地按顺序重建消息流:
索引的原型设计与基准测试
就像任何性能优化工作一样,我们必须进行基准测试以验证我们的确在改进系统。由于消息发布逻辑处于 Aria 的关键路径上,我们还希望进行广泛的测试。
Theodor 首先编写了一个工具来分析各种恢复场景。这样,我们就可以测试不同的配置,例如主题分区的数量、交错程度、读取器的数量等等,并观察更改这些变量如何影响系统的性能。
有了基准测试之后,他实现了主题分区索引的初始版本。当我们对这一实现进行分析时,发现最小堆是代码中最大的瓶颈。在 AI 出现之前,我们可能只会选择一个看起来更优的单一实现。但如今,运行实验的成本很低:Theodor 提示一个智能体启动了五种不同的堆实现并让它们整夜运行性能分析。第二天,我们就得到了答案:fast_heap_unboxed 为我们的索引恢复代码带来了 2 倍的性能提升。
Theodor 对新索引进行了大量 expect 测试,在 Antithesis 中对新逻辑进行了充分演练,最后还让一大批智能体以极高的严谨度对代码进行了分析。
使用块池来存储索引
设计好索引数据结构之后,我们需要找出一种高效的表示方式。我们不想为每个索引都创建一个环形缓冲区,因为环形缓冲区并不能真正地动态调整大小。因此,它们必须按照容纳最坏情况所需的大小来设置。具体而言,索引大小与消息大小成反比(消息越小,能放入 tip 存储中的消息就越多,这就意味着您需要一个更大的索引)。Aria 的消息可以小至 32 字节。如果整个 tip 存储全部由如此小的消息组成,那么对应的索引将达到 2GB。为每个主题分区保留一个 2GB 的索引会浪费太多内存。
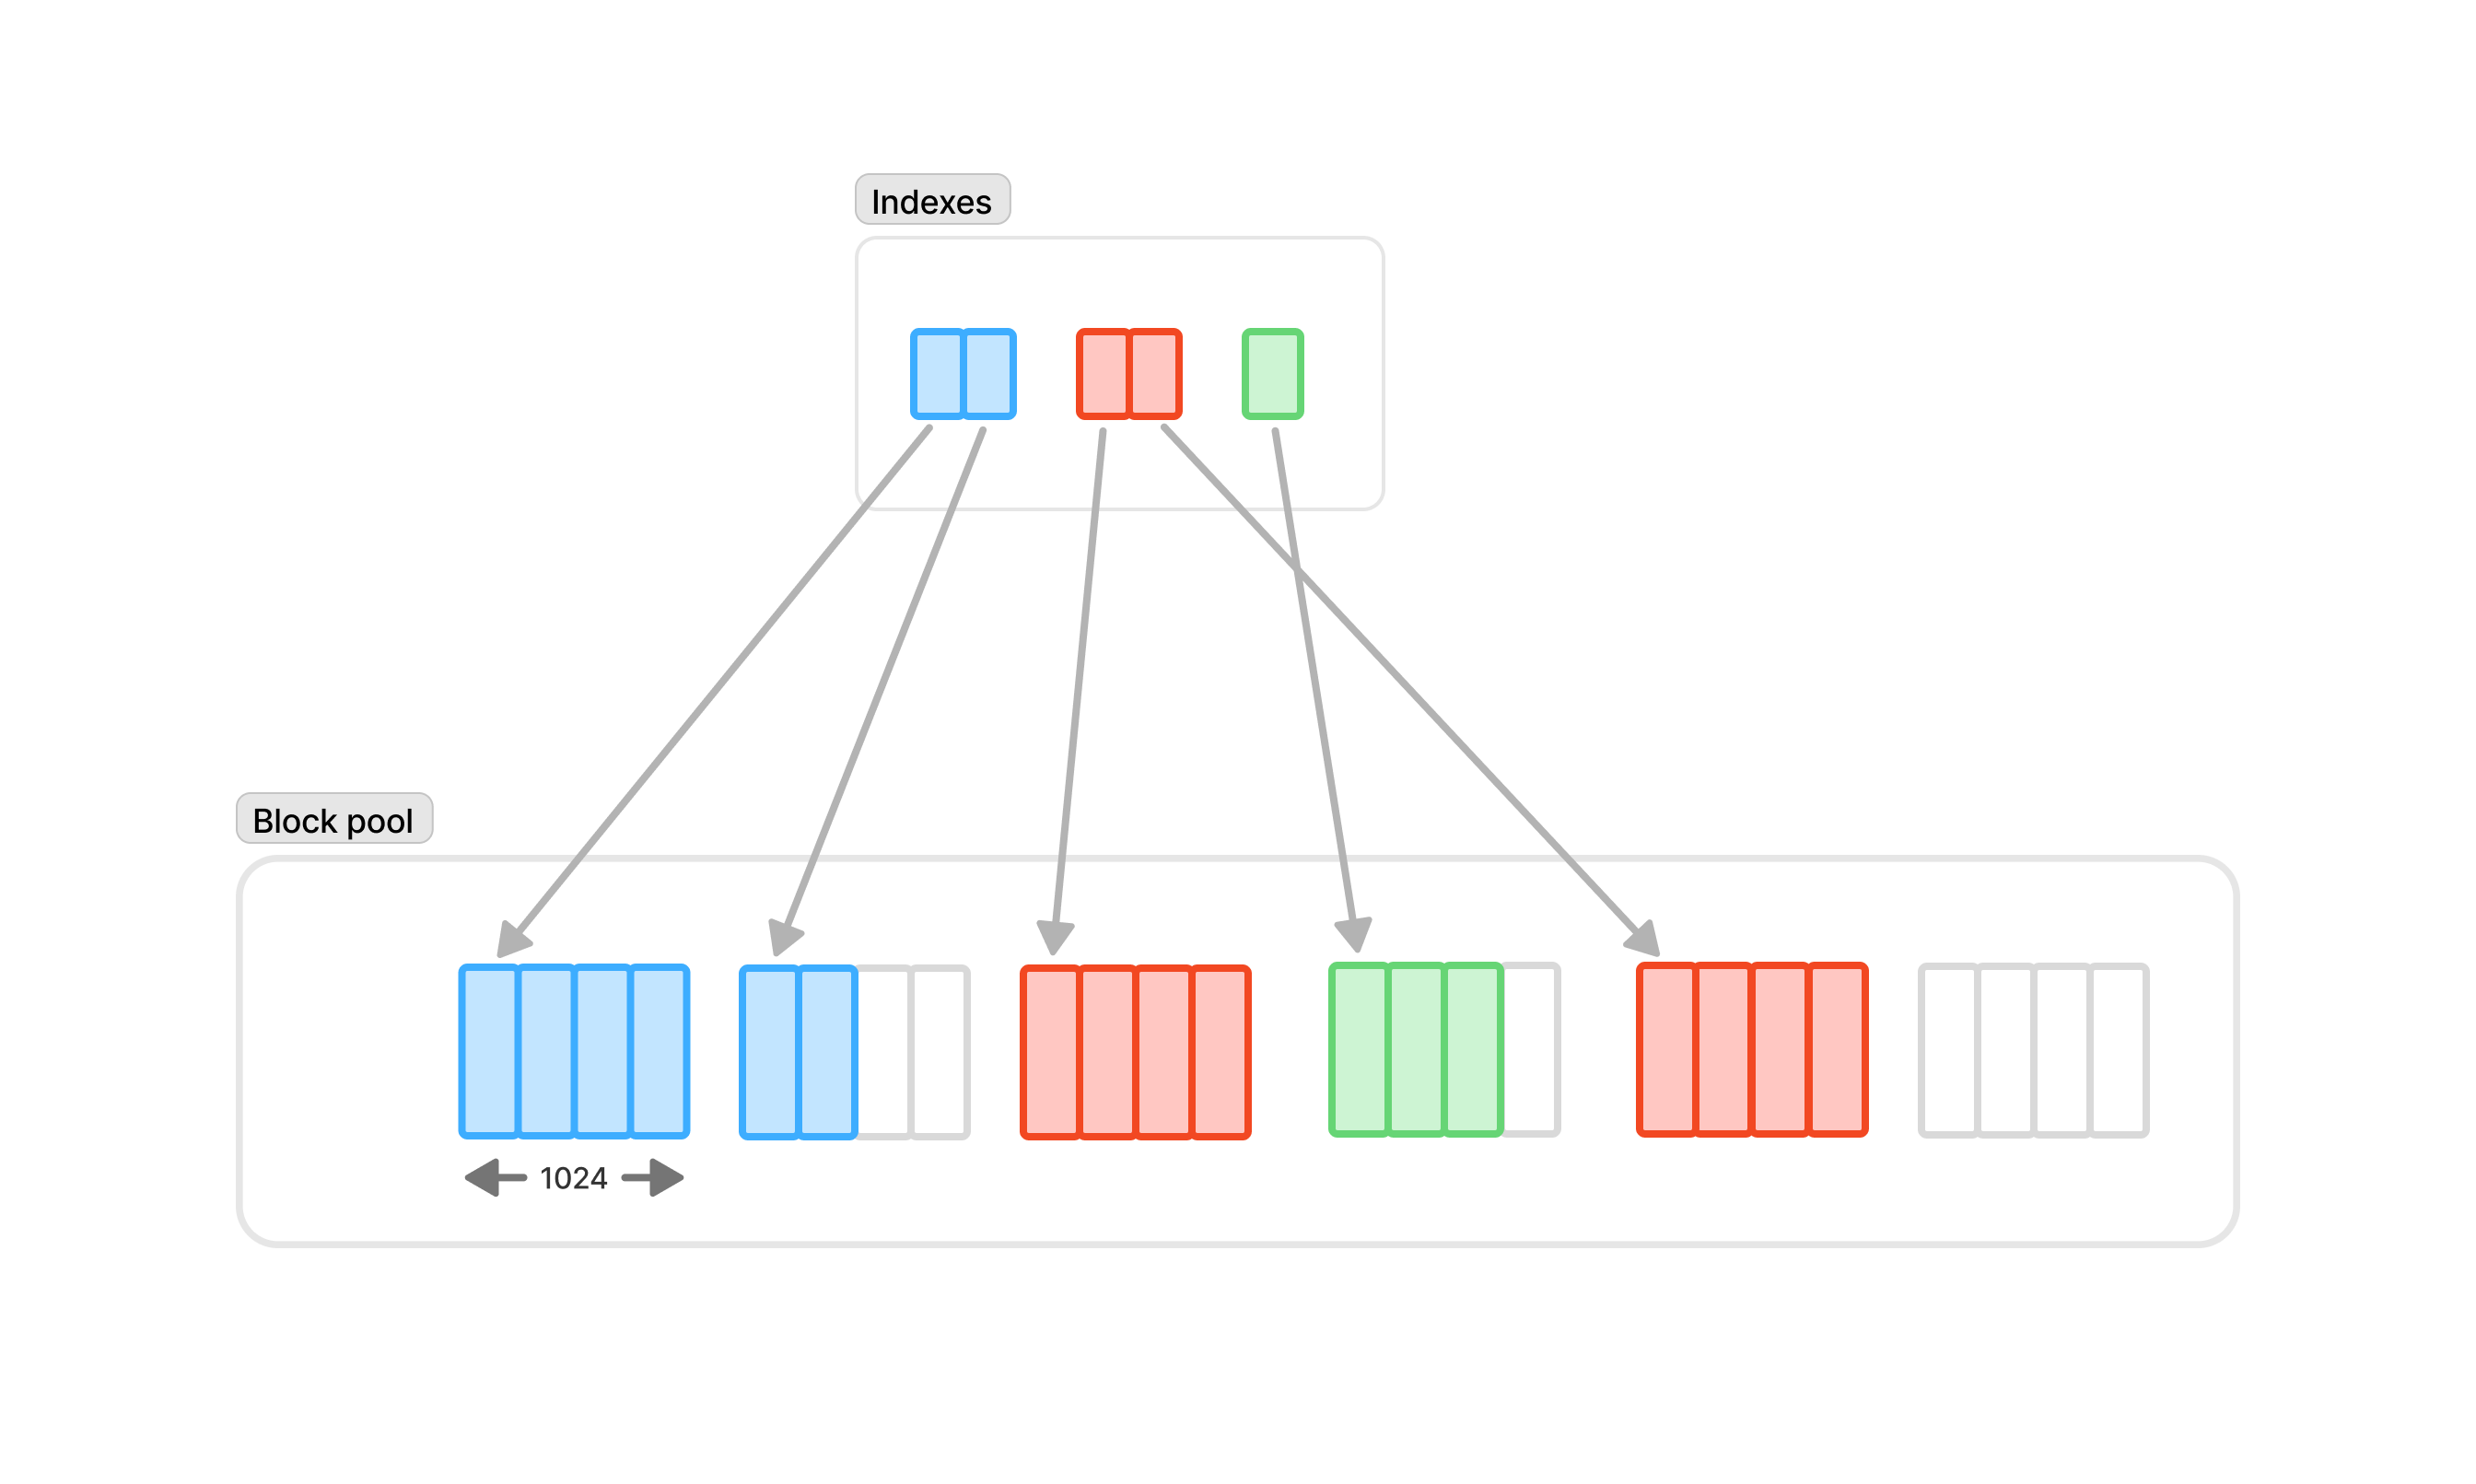
我们转而希望索引能够随着其主题分区中消息数量的增减而动态伸缩。
我们最终采用的方法是使用一个由若干块组成的共享池,每个块包含 1024 个条目。索引指向某个块并向其中插入值。一旦块中所有消息都已离开环形缓冲区,就可以从索引中弹出这些块,并将其重新用于其他索引:
读取旧消息耗时过长
Theodor 在索引方面的工作解决了我们 tip 恢复的难题,但我们还有另一个消息投递方面的问题:需要来自流 tip 之前的消息的客户端等待时间过长。
当客户端重启时,它经常请求其订阅主题自本周开始以来的所有消息。我们将这一过程称为 初始恢复。初始恢复可能涉及数百万乃至 数十亿 条消息。Aria 必须以尽可能快的速度读取这些消息并将其交付给客户端,这一点至关重要。此外,客户端往往会在差不多同一时间重启,因此这一过程的良好伸缩性显得尤为重要。
在一次具体事件中,通常在 2.5 秒以内即可完成的初始恢复竟然耗时超过 13 分钟。当我们深入排查原因时,发现了困扰 tip 存储的同样问题:Aria 读取和过滤的数据量比它实际需要发送的多出 10 倍。显然,我们需要重新思考消息在磁盘上的存储方式。
Aria 将消息持久化存储在子树存储中
Aria 最初会按时间顺序把消息以分段的形式存储在磁盘上,每个主题分区对应一组分段。然后,一个独立进程会读取这些分段,并将它们拆分成多个 子树存储(subtree store),每个子树存储中包含某个主题子树的消息。这些子树存储旨在在两种做法之间取得平衡:写入大量文件(这样过滤效率高,但重新组合成消息流时工作量较大),与写入较少文件(重新组合更容易,但过滤效率较低)。
为了完成这种拆分,Aria 此前一直采用一种简单的启发式策略:它会读取主题的前三个分段来决定子树存储。因此,如果我们有 app/options/orders/created 和 app/options/orders/cancelled 这两个主题,它们都会放入 app/options/orders 对应的子树存储中。如果某个主题的分段少于三个,则会单独放入一个子树存储;例如,app/options 会拥有自己的存储。这种启发式策略实际上让主题分区的每个直接子项各自占用一个子树存储。
然而,当某个存储中一个主题的消息量远大于其他主题时,这种启发式策略效果并不理想。如果客户端只订阅那个不太活跃的主题,Aria 就必须过滤掉其他主题的所有消息。和提示恢复(tip recovery)的情况一样,这种过滤会产生大量开销。
更宏观地看,我们不希望用户在使用 Aria 时为了设计合理的主题结构而不得不了解这一特定的内部实现细节。我们希望用户按照对自己有意义的方式来组织主题结构,并且能够放心地认为 Aria 会智能地完成拆分工作。
Theodor 负责开发一种算法,能够基于每个主题的消息量智能地拆分主题树来解决这个问题。由于 Aria 在持久化消息流之后才进行这一分段处理步骤,因此它能够计算出每个主题的消息量。
收集数据并测试不同算法
和提示恢复的实现一样,Theodor 在自适应拆分方面的工作也需要尝试多种方案。他首先从多个 Aria 会话中收集数据,用于测试不同的算法。接着他实现了若干种拆分算法,并把这些算法在收集到的数据上运行。Theodor 从多个角度分析了这些结果,例如:
- 如果读取某个主题,我们需要从一个存储中跳过多少字节?
- 在所有主题上,这些“浪费的字节”之和是多少?
- 如果读取一个主题,会造成最多的字节浪费?
- 如果读取一个主题,总字节数与有用字节数的比例最差会是多少?
和之前一样,这一探索过程也借助了 LLM。Theodor 能够快速地 vibe-code(凭直觉编程)出一个 Web UI,将不同的切分算法在真实数据集上的效果可视化出来。
最终的算法
最终 Theodor 选择了一种将贪心聚类算法与二分查找相结合的方案。它满足了我们期望的特性:消息量大的主题拥有自己的子树存储,而较小的主题则被归并到同一个存储中。
下面是使用先前启发式算法得到的一个主题树示例:
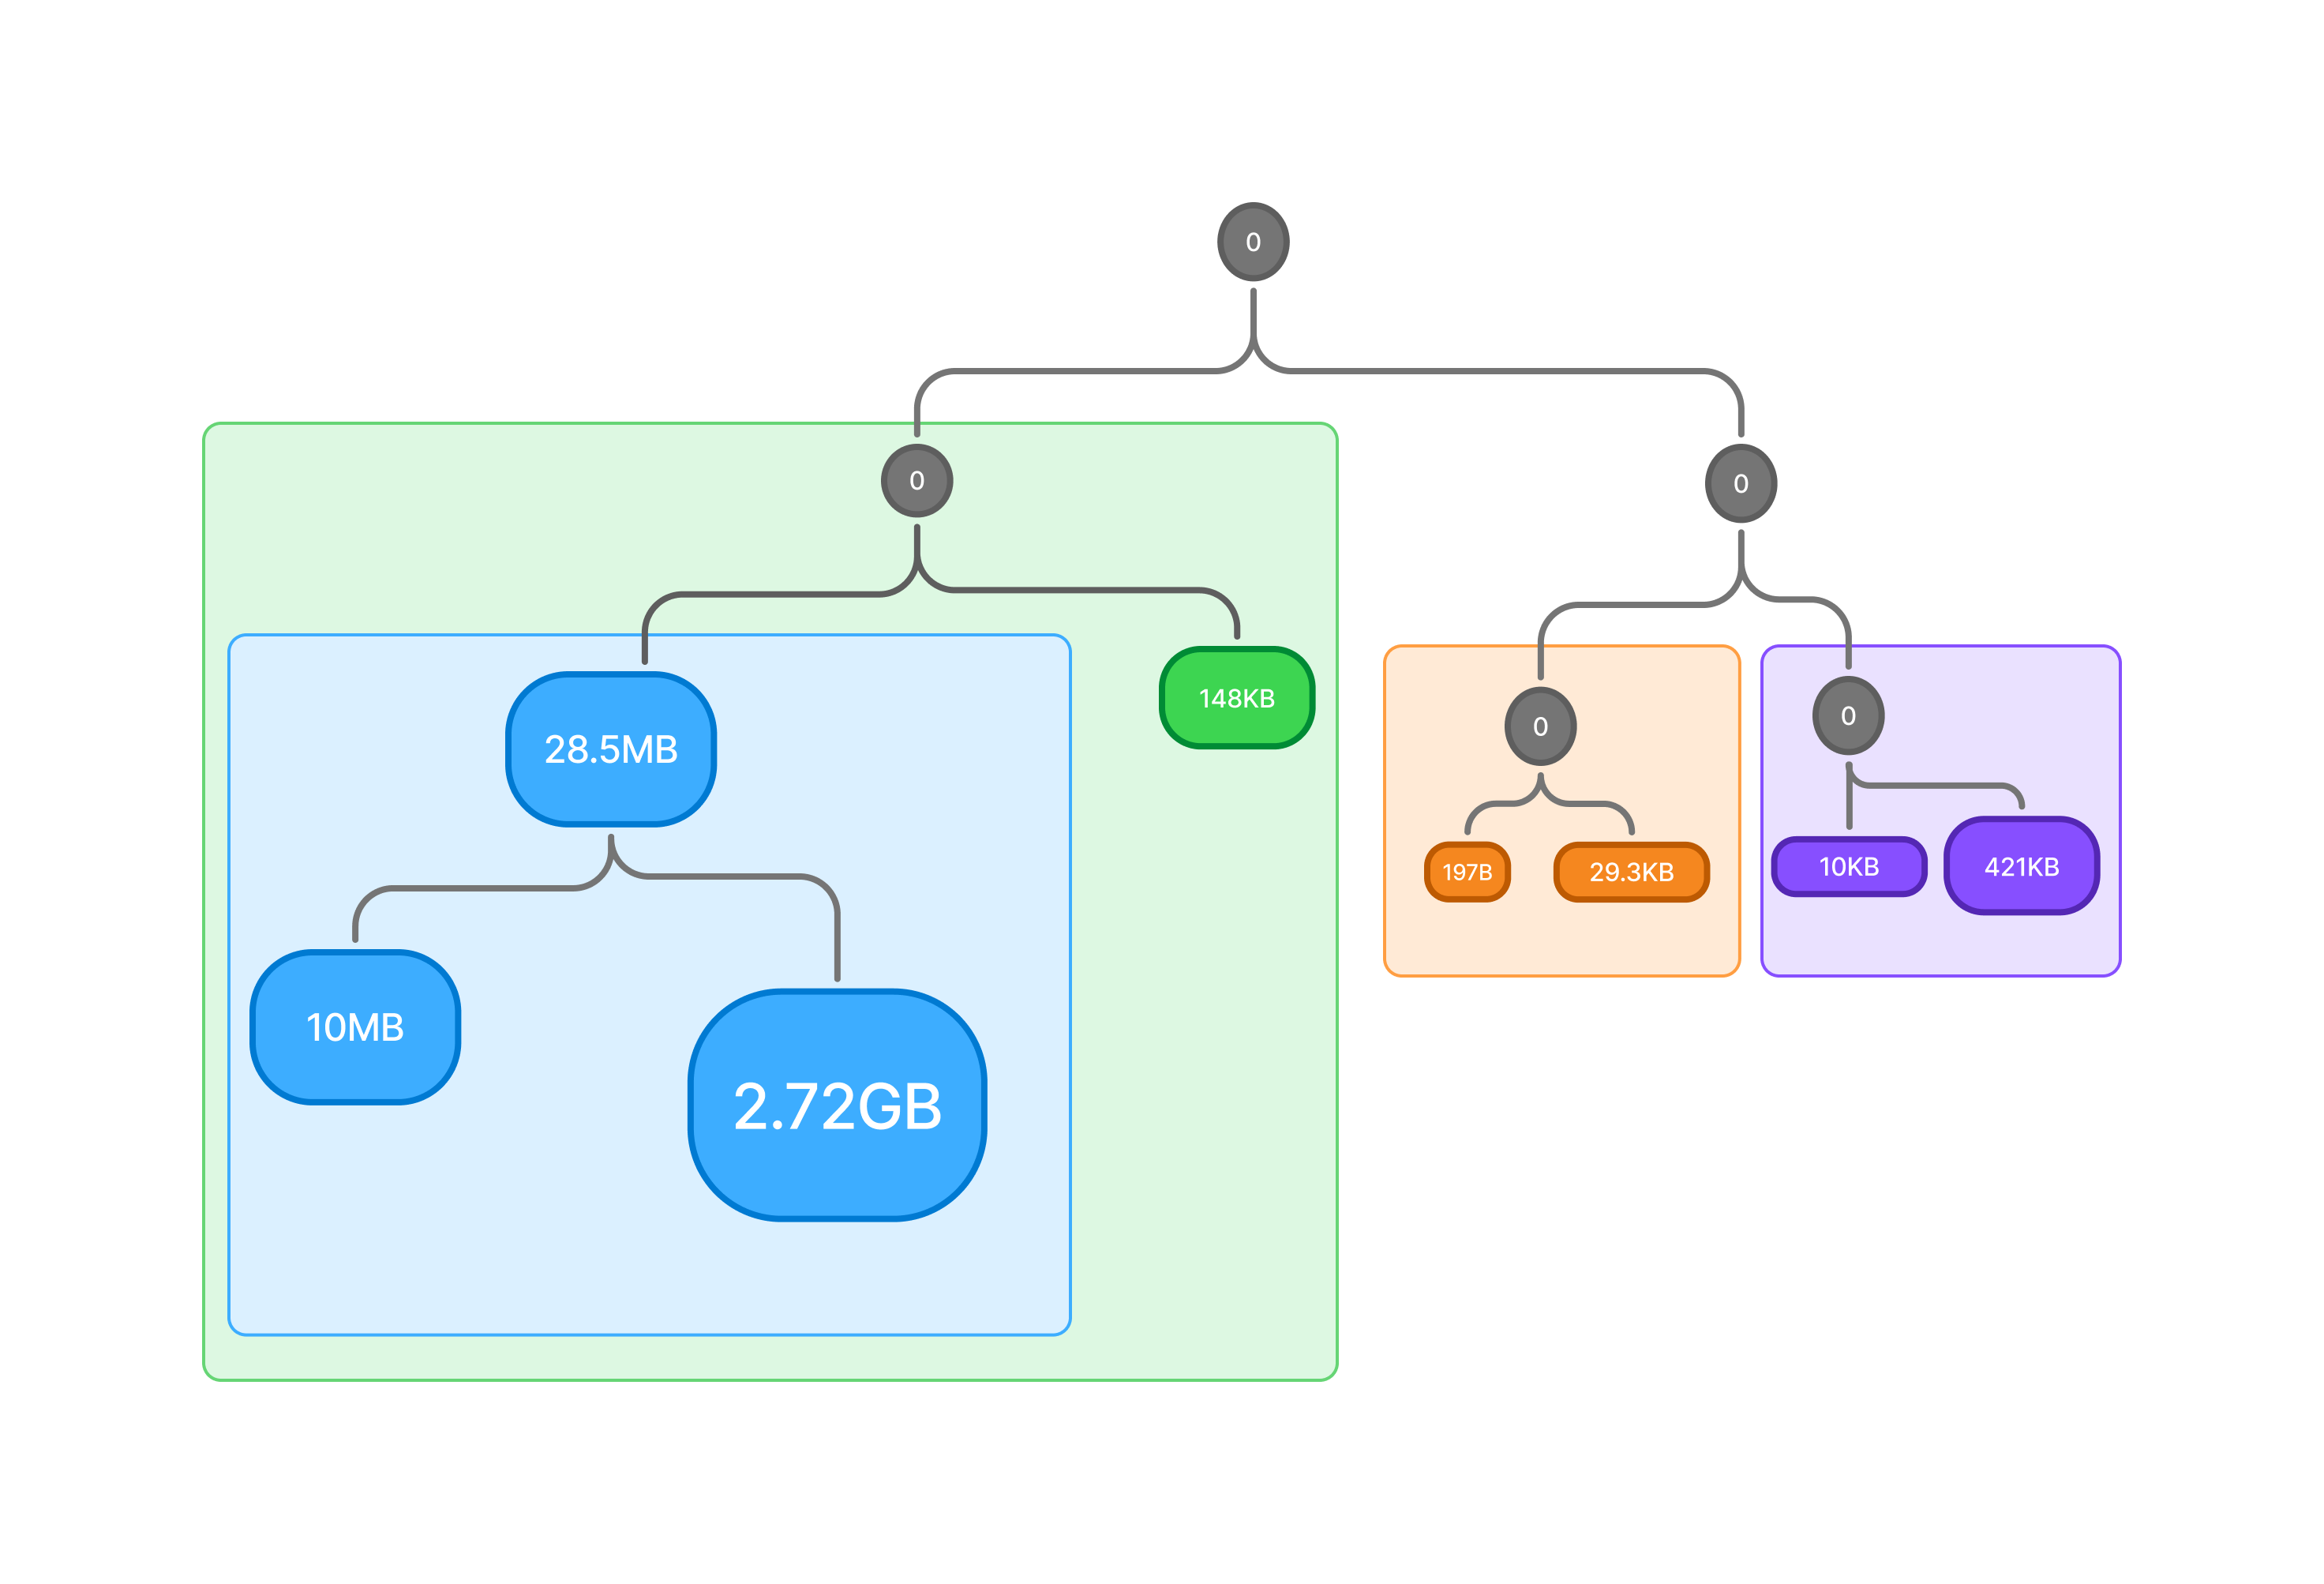
注意,2.72GB 的主题与 10MB 和 28.5MB 的主题位于同一个存储中。这意味着如果有人想要读取 10MB 的主题,就必须过滤掉其他所有消息。与此同时,那些较小的主题却被拆分到了三个不同的存储中,尽管它们比大主题小了若干个数量级。
使用新的自适应切分算法后,同一棵树看起来是这样的:
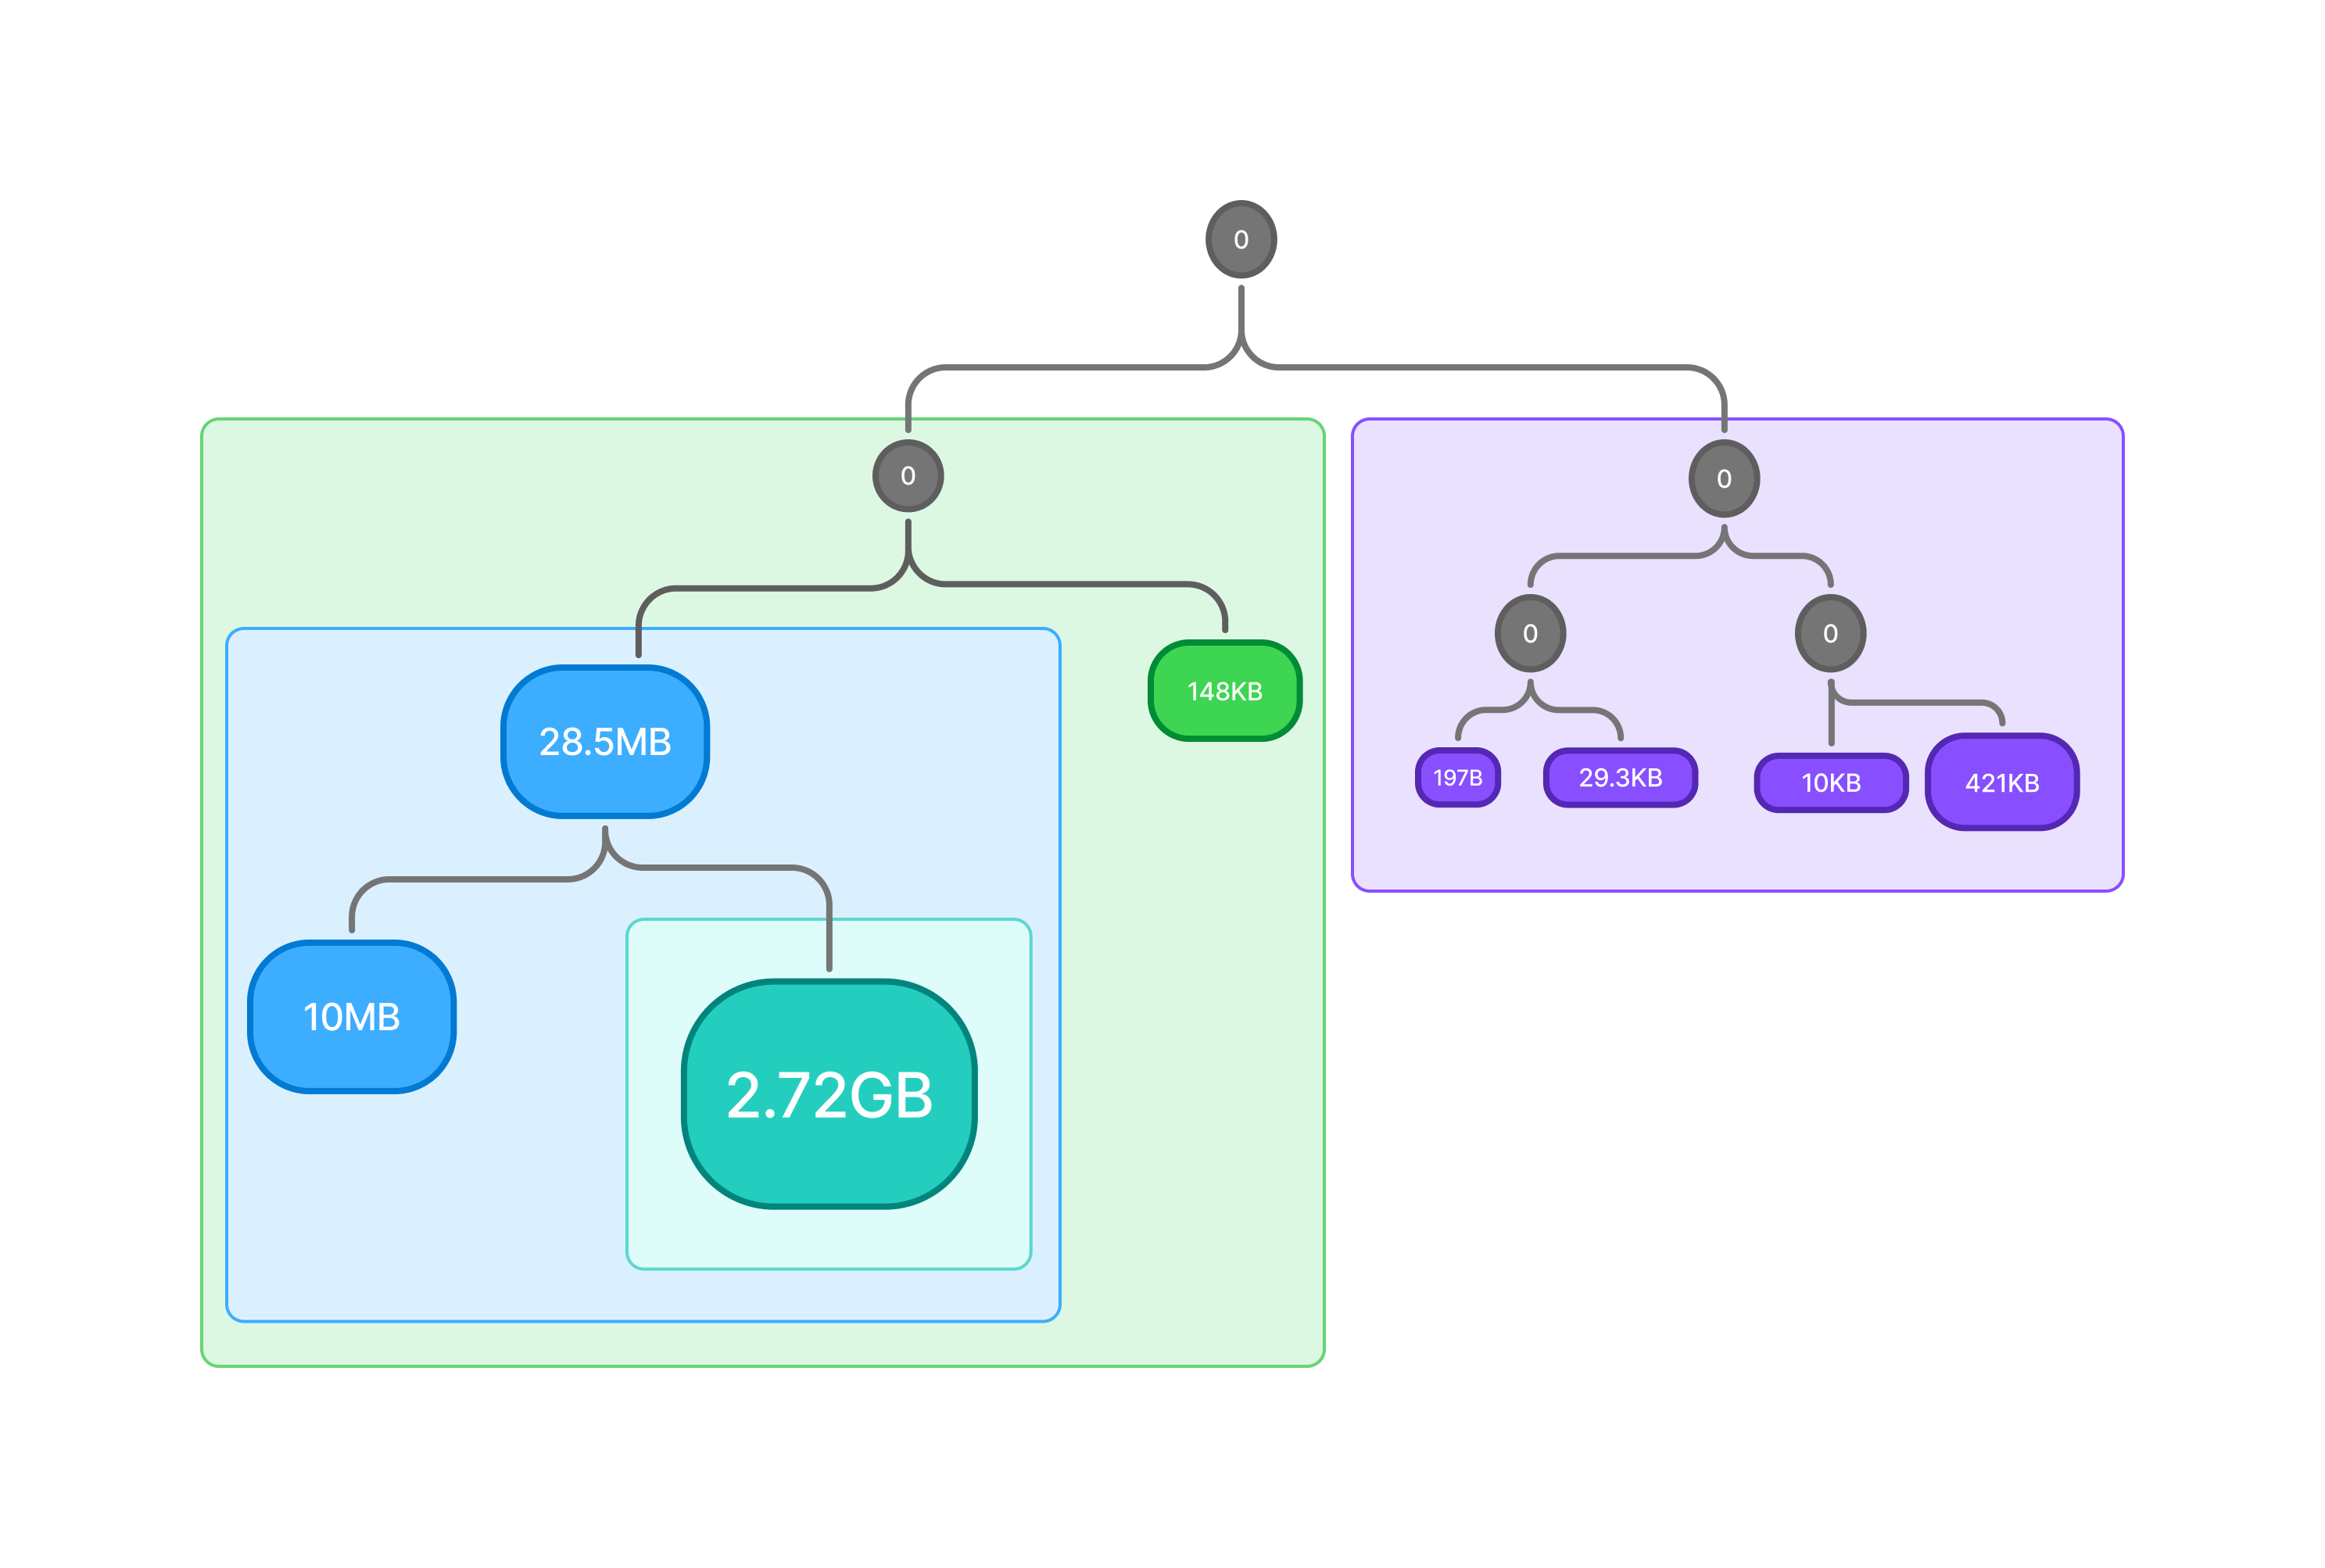
现在 2.72GB 的 topic 拥有自己独立的存储,与 28.5MB 和 10MB 的 topic 分开,而较小的 topics 则全部捆绑到一个共享存储中。
在算法上使用多种测试策略
由于自适应拆分会直接影响消息在 Aria 中的存储方式,我们希望以极高的确定性确保没有 bug。丢失或重排消息会造成严重后果。
我们首先使用 expect 测试来检查算法的各种属性,例如大型 topic 拥有自己的存储、较小的兄弟 topic 共享存储,等等。
对于消息一致性,我们已经有了一个现有的基于属性的测试,它在随机选择的 topics 上插入一系列随机生成的消息,然后运行拆分算法。该测试读取 topic 树的随机片段,并确认消息具有正确的顺序和内容。Theodor 扩展了该测试,对树的拆分进行随机化处理,从而确认无论 topic 树如何拆分,消息内容都保持不变。
最后,我们在 Antithesis 中进行了多次运行,以确认这些更改没有破坏 Aria 中的其他部分。
优化效果如何?
tip 索引代码已经部署到生产环境。我们在 staging 环境中看到了初步结果,在某些真实场景中 CPU 使用率降低了 30%。在这些时段内,各客户端的整体延迟显著下降。我们注意到,未实现该索引的服务器上出现了一些多秒级的尾部延迟,而运行新代码的服务器上则完全没有出现这些问题。
自适应拆分已部署到我们的 staging 环境,并即将在生产环境中运行。
Nicholas 是 Jane Street 的软件工程师和技术作者。他写过很多关于辣椒油的博客文章。
来源:Hacker News · blog.janestreet.com